Een server kan elke health check doorstaan en toch nog maar enkele uren van een crash verwijderd zijn. Een geheugenlek, een out-of-memory-kill of een vollopende schijf herken je nooit aan één enkele meting. Het is een trend die je alleen ziet door vandaag te vergelijken met de afgelopen dagen. In dit artikel lees je hoe je elk van deze drie problemen opmerkt voordat ze een herstart afdwingen, een proces beëindigen of schrijfacties blokkeren, en hoe je het bewaken automatiseert, zodat je er zelf niet aan hoeft te denken.
Waarom deze problemen tussen de checks door verborgen blijven
Een monitor die elke minuut je homepage pingt, vertelt je dat de site online is, tot precies het moment dat hij dat niet meer is. Geheugenlekken, vollopende schijven en herhaalde out-of-memory-kills (OOM-kills) zijn allemaal snelheidsproblemen, geen statusproblemen. Bij elke afzonderlijke meting zien ze er volkomen normaal uit en ze verraden zich pas als een stijgende lijn over uren of dagen. Tegen de tijd dat een dashboard rood kleurt, heeft de server meestal al een service herstart, een proces beëindigd of gestopt met het accepteren van schrijfacties.
Daarom heb je voor vroege detectie historie nodig, niet alleen een actuele waarde: je zoekt naar "dit getal is een week lang elke dag gestegen" in plaats van "dit getal is nu hoog". Onze gids over servermetrics lezen als trends versus sprongen behandelt de algemene techniek; dit artikel past die toe op de drie storingen die het vaakst voor een oproep om 2 uur 's nachts zorgen.
Een geheugenlek herkennen vóór de herstart
Een geheugenlek heeft een kenmerkend patroon: het gebruik stijgt gestaag, misschien 3-5% per dag, en daalt pas weer als het proces of de server herstart. Door dat patroon kan een server dagenlang tussen herstarts kerngezond lijken. Het lek valt alleen op als je naar de helling kijkt, niet naar het actuele getal.
Op Linux stelt cgroup v2 per control group een memory.events-bestand beschikbaar met een oom_kill-teller, en elk proces heeft een oom_score die de OOM killer van de kernel gebruikt om te bepalen wat er wordt opgeofferd als het geheugen opraakt. Eén stijging is op zichzelf niet genoeg om van een lek te spreken: een drukke week kan er hetzelfde uitzien. Wat een lek bevestigt, is dat het patroon zich herhaalt over minstens twee herstarts, waarbij het geheugen telkens betrouwbaar daalt.
$ free -h
              total        used        free      shared  buff/cache   available
Mem:           7.8G        7.1G        180M        210M        512M        420M
$ systemctl status myapp.service | grep Memory
     Memory: 6.8G (limit: 7.0G)
Als je myapp.service herstart en het geheugen elke keer terugzakt naar een basisniveau, kijk je niet naar normale belasting, maar naar een lek in die specifieke service.
Als de OOM killer processen begint uit te schakelen
Als het vrije geheugen opraakt, stopt de OOM killer van de kernel een proces om geheugen terug te winnen. Waar dat proces mee bezig was, eindigt abrupt: een databaseverbinding valt weg, een queue-job verdwijnt halverwege, en de server ziet er direct daarna vaak weer prima uit, omdat het geheugen net is vrijgemaakt. Dat maakt deze storing zo verraderlijk: hij verschijnt zelden als langdurig hoog geheugengebruik, maar alleen als een plotselinge daling gevolgd door een fout ergens anders in je stack.
In gecontaineriseerde omgevingen is het kenmerk duidelijker: een proces dat op deze manier is beëindigd, stopt met exitcode 137 (128 + signaal 9), en in Kubernetes staat de podstatus op OOMKilled. Buiten containers vind je in dmesg het eigen logboek van de kernel:
$ dmesg -T | grep -i 'killed process'
[Tue Oct 28 02:14:11 2025] Killed process 18422 (node) total-vm:2145728kB
Een paar veelvoorkomende exitcodes die je moet herkennen bij het analyseren van een crash:
| Exitcode | Betekenis |
|---|---|
| 137 | Beëindigd door SIGKILL, vaak de OOM killer |
| 139 | Segmentation fault (SIGSEGV) |
| 143 | Beëindigd door SIGTERM, vaak een nette stop |
| 1 | Algemene applicatiefout |
Eén OOM-kill kan een eenmalige piek zijn. Drie of meer in een week op dezelfde server is een patroon dat je moet oplossen: geef de boosdoener een harde geheugenlimiet, zodat hij voorspelbaar faalt in plaats van andere processen mee te sleuren, of geef de server meer geheugen. Beheer je de service met systemd, combineer die limiet dan met een verstandig herstartbeleid, zodat een kill niet tot langdurige downtime leidt:
[Service]
MemoryMax=512M
Restart=on-failure
RestartSec=5s
Schijf vol: bytes en inodes zijn twee verschillende problemen
Een schijf zonder ruimte en een schijf zonder inodes zien er van buitenaf identiek uit: schrijfacties mislukken met ENOSPC, "no space left on device", maar df -h vertelt je alleen iets over het eerste. Elk bestand gebruikt één inode, ongeacht de grootte, dus een schijf vol kleine bestanden (een cache, een mailqueue, PHP-sessies) kan nog volop vrije bytes melden en toch helemaal vol zijn:
$ df -h /
Filesystem      Size  Used Avail Use% Mounted on
/dev/sda1        40G   38G  1.2G  97% /
$ df -i /
Filesystem      Inodes  IUsed   IFree IUse% Mounted on
/dev/sda1      2621440 2621440      0  100% /
WarningEen schone
df -h-uitvoer sluit een volle schijf niet uit. Controleer altijd ookdf -i: bij uitgeputte inodes mislukken schrijfacties precies zoals bij een gebrek aan bytes, maar een grotere schijf lost het niet op. Kleine bestanden opruimen wel.
ext4-bestandssystemen reserveren standaard ook ongeveer 5% van de blokken voor root (tune2fs -m). Daarom toont df -h een bestandssysteem soms al als "vol" voor gewone gebruikers, kort voordat het echt geen ruimte meer heeft. Die marge bestaat om systeemprocessen iets langer te laten schrijven.
Hoe dan ook is het bruikbare signaal hetzelfde als bij geheugen: een schijf die in een gestaag tempo groeit en binnen een bekend aantal dagen zijn limiet bereikt, is een probleem dat je kunt inplannen, in plaats van een probleem dat je om 3 uur 's nachts wakker belt.
Alle drie bewaken zonder eraan te hoeven denken
Handmatig dmesg, free en df -i draaien op al je servers schaalt niet verder dan een handvol machines, en het hangt ervan af of iemand eraan denkt te kijken voordat het misgaat. De monitoring van InfraNest let op precies deze drie langzaam opbouwende problemen op elke server waarop de agent draait, en toont ze op je Home-pagina, de pagina van de betreffende server of het betreffende volume en het serveroverzicht, in plaats van ze te begraven in een logregel.
Bij een lek noemt het de specifieke service of container waarvan het geheugen blijft groeien, zodra hetzelfde stijg-en-reset-patroon zich over minstens twee herstarts heeft voorgedaan. Bij OOM-kills markeert het een server zodra er in een week drie of meer processen op deze manier zijn beëindigd, en wijst het je direct op wat het meeste geheugen gebruikt. Bij een vollopend volume extrapoleert het het huidige tempo en vermeldt het volume zodra het binnen twee weken vol dreigt te raken, weergegeven bij het volume zelf als het een cloudvolume is, want dat is wat je in de praktijk zou vergroten.
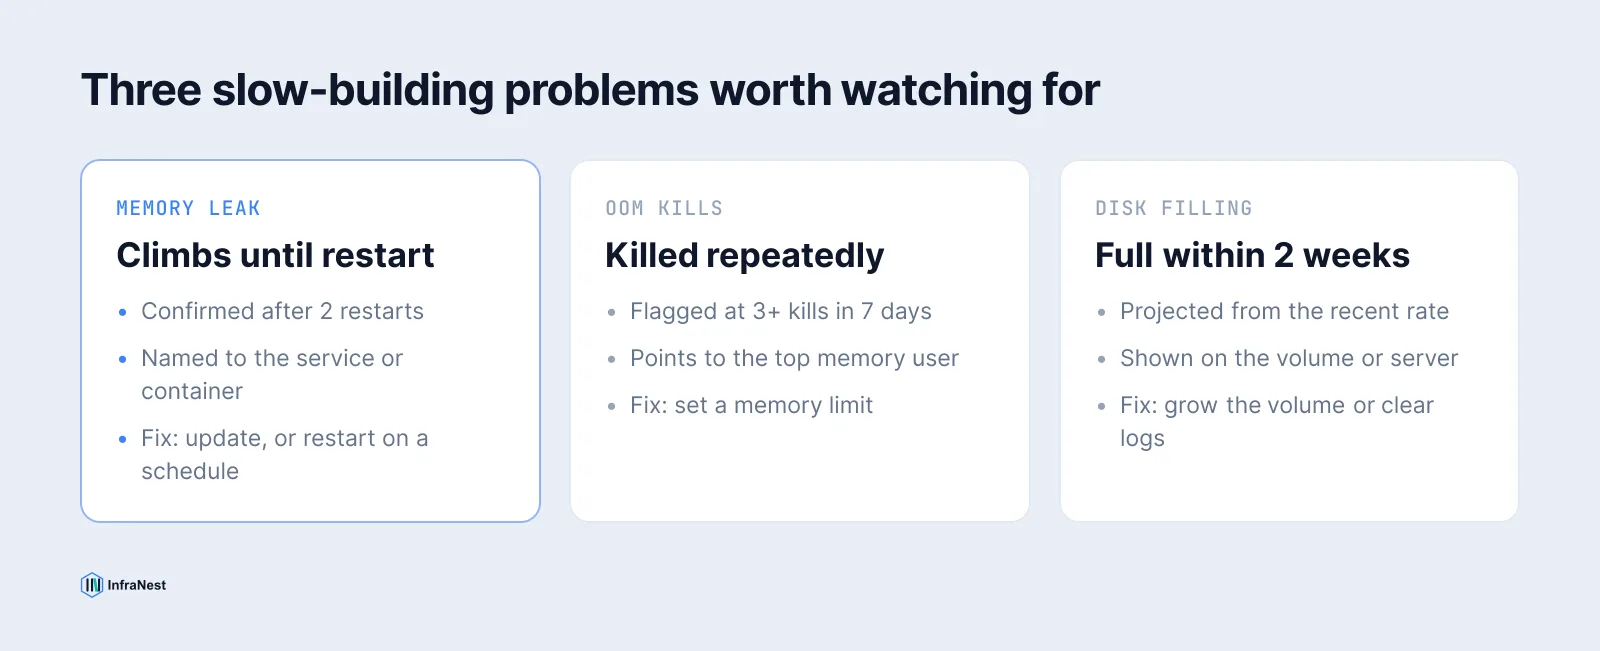
Die voorspelling werkt alleen omdat recente dagen worden vergeleken, niet één meting. Dat is hetzelfde principe als bij trends versus eenmalige sprongen lezen in servermetrics in het algemeen, en bij website- en servermonitoring die echt langzame storingen opvangt in plaats van alleen uitval.
Oplossen: eerst tijd winnen, dan de oorzaak aanpakken
- Geheugenlek: de betreffende service volgens een schema herstarten (bijvoorbeeld 's nachts) levert tijd op zonder de hele server te herstarten, terwijl je de echte oplossing uitrolt, wat vaak gewoon een update is.
- Herhaalde OOM-kills: geef de grootste boosdoener een harde geheugenlimiet zodat hij voorspelbaar faalt, of voeg geheugen toe aan de server als niets duidelijk misgaat.
- Vollopende schijf: vergroot het volume als het een cloudschijf is, of ruim de gebruikelijke verdachten op (oude logs, back-ups, vastgelopen queues) als hij lokaal is.
- Vollopende inodes: een grotere schijf helpt zelden; zoek de map die de meeste kleine bestanden aanmaakt en ruim die op.
Geen van deze problemen is een noodgeval als je ze een week van tevoren opmerkt. Allemaal zijn ze een noodgeval als je ze pas ziet wanneer de schijf al vol is of de service al plat ligt.
Richt je dit in voor een heel serverpark in plaats van één machine, bekijk je servers dan samen met hun monitors, zodat een langzaam lek op één machine geen apart onderzoek vergt los van de storing die het uiteindelijk veroorzaakt.
Klaar om het niet langer van een klant te horen? Stel servermonitoring in en laat het lek, het kill-patroon en de vollopende schijf signaleren voordat een van hen downtime veroorzaakt.
Veelgestelde vragen
#Hoeveel herstarts zijn er nodig om een geheugenlek te bevestigen?
Eén stijging in geheugengebruik is niet genoeg: een drukke week kan er hetzelfde uitzien als een lek. Het betrouwbare signaal is hetzelfde stijg-en-reset-patroon dat zich herhaalt over minstens twee herstarts van de service of server, waarbij het geheugen telkens consequent terugzakt naar een basisniveau.
#Waarom toont een schijf vrije ruimte maar mislukken schrijfacties toch?
Waarschijnlijk zijn de inodes op, niet de bytes. Elk bestand gebruikt één inode, ongeacht de grootte, dus een schijf vol kleine bestanden zoals cache-items of sessiegegevens kan in df -h volop vrije ruimte melden, terwijl df -i 100% gebruik toont.
#Welke exitcode betekent dat een proces is beëindigd wegens geheugentekort?
Op Linux stopt een proces dat door de out-of-memory killer is beëindigd doorgaans met exitcode 137 (128 plus signaal 9, SIGKILL). In Kubernetes toont de podstatus bij dezelfde gebeurtenis daarnaast OOMKilled.
#Moet ik iets op de server installeren om deze problemen op te sporen?
Geheugen, schijfruimte en de geschiedenis van OOM-kills worden doorgaans niet beschikbaar gesteld via de eigen API van een cloudprovider. Om ze betrouwbaar te detecteren is daarom een agent op de server zelf nodig, in plaats van alleen te vertrouwen op metrics van de provider.
Probeer het met een gratis tool
Was dit artikel nuttig?