Un serveur peut réussir tous ses contrôles de santé et n'être pourtant qu'à quelques heures de tomber. Le signe d'une fuite mémoire, d'un arrêt par manque de mémoire (OOM kill) ou d'un disque qui se remplit n'est jamais une mesure isolée : c'est une tendance, que l'on ne voit qu'en comparant aujourd'hui aux derniers jours. Cet article explique comment repérer chacun de ces trois problèmes avant qu'il n'impose un redémarrage, ne tue un processus ou ne bloque une écriture, et comment automatiser la surveillance pour ne pas avoir à penser à vérifier.
Pourquoi ces problèmes passent entre les mailles des contrôles
Une sonde qui interroge votre page d'accueil toutes les minutes vous dira que le site est en ligne jusqu'au moment précis où il ne l'est plus. Les fuites mémoire, le remplissage du disque et les arrêts répétés par manque de mémoire (OOM, pour out-of-memory) sont tous des problèmes de rythme, pas d'état : ils paraissent parfaitement normaux sur n'importe quelle mesure isolée et ne se révèlent que sous la forme d'une pente sur plusieurs heures ou plusieurs jours. Le temps qu'un tableau de bord passe au rouge, le serveur a généralement déjà redémarré un service, tué un processus ou cessé d'accepter les écritures.
C'est pourquoi les repérer tôt exige un historique, et pas seulement une valeur actuelle : on cherche « cette valeur a augmenté chaque jour pendant une semaine » plutôt que « cette valeur est élevée en ce moment ». Notre guide sur la lecture des métriques serveur : tendances ou pics ponctuels présente la technique générale ; cet article l'applique aux trois pannes qui déclenchent le plus souvent une alerte à 2 h du matin.
Détecter une fuite mémoire avant le redémarrage
Une fuite mémoire a une forme caractéristique : l'utilisation augmente régulièrement, de 3 à 5 % par jour par exemple, et ne redescend que lorsque le processus ou le serveur redémarre. À cause de cette forme, un serveur peut sembler en parfaite santé pendant des jours entre deux redémarrages : la fuite n'apparaît que si l'on surveille la pente, et non la valeur actuelle.
Sous Linux, cgroup v2 expose pour chaque groupe de contrôle un fichier memory.events contenant un compteur oom_kill, et chaque processus possède un oom_score que l'OOM killer du noyau utilise pour décider quoi sacrifier lorsque la mémoire vient à manquer. Une hausse isolée ne suffit pas à conclure à une fuite : une semaine chargée peut produire la même courbe. Ce qui confirme une fuite, c'est la répétition du schéma sur au moins deux redémarrages, avec une mémoire qui redescend systématiquement à chaque fois.
$ free -h
              total        used        free      shared  buff/cache   available
Mem:           7.8G        7.1G        180M        210M        512M        420M
$ systemctl status myapp.service | grep Memory
     Memory: 6.8G (limit: 7.0G)
Si vous redémarrez myapp.service et que la mémoire retombe à chaque fois à un niveau de base, il ne s'agit pas d'une charge normale : vous êtes face à une fuite dans ce service précis.
Quand l'OOM killer commence à tuer des processus
Lorsque la mémoire libre est épuisée, l'OOM killer du noyau arrête un processus pour la récupérer. Ce que faisait ce processus s'interrompt brutalement (une connexion à la base de données tombe, une tâche de file d'attente disparaît en pleine exécution) et le serveur semble souvent de nouveau normal juste après, puisque la mémoire vient d'être libérée. C'est ce qui rend ce type de panne sournois : il se manifeste rarement par une mémoire élevée en continu, mais plutôt par une chute soudaine suivie d'une erreur ailleurs dans votre stack.
Dans les environnements conteneurisés, la signature est plus nette : un processus tué de cette manière se termine avec le code 137 (128 + signal 9), et dans Kubernetes le statut du pod indique OOMKilled. Hors conteneurs, consultez dmesg pour voir la trace laissée par le noyau :
$ dmesg -T | grep -i 'killed process'
[Tue Oct 28 02:14:11 2025] Killed process 18422 (node) total-vm:2145728kB
Quelques codes de sortie courants à savoir reconnaître lors de l'analyse d'un crash :
| Code de sortie | Signification |
|---|---|
| 137 | Tué par SIGKILL — souvent l'OOM killer |
| 139 | Erreur de segmentation (SIGSEGV) |
| 143 | Terminé par SIGTERM — souvent un arrêt propre |
| 1 | Erreur applicative générique |
Un OOM kill isolé peut n'être qu'un pic ponctuel. Trois ou plus en une semaine sur le même serveur constituent un schéma qui mérite d'être corrigé : soit vous imposez une limite mémoire stricte au service en cause pour qu'il échoue de façon prévisible au lieu d'entraîner les autres dans sa chute, soit vous ajoutez de la mémoire au serveur. Si le service est géré par systemd, associez cette limite à une politique de redémarrage raisonnable pour qu'un arrêt ne se transforme pas en interruption prolongée :
[Service]
MemoryMax=512M
Restart=on-failure
RestartSec=5s
Disque plein : octets et inodes sont deux problèmes différents
Un disque à court d'espace et un disque à court d'inodes se ressemblent vu de l'extérieur : les écritures échouent avec ENOSPC, « no space left on device ». Mais df -h ne vous renseigne que sur le premier cas. Chaque fichier consomme un inode quelle que soit sa taille, si bien qu'un disque rempli de petits fichiers (un cache, une file d'attente de mails, des sessions PHP) peut afficher beaucoup d'octets libres tout en étant complètement plein :
$ df -h /
Filesystem      Size  Used Avail Use% Mounted on
/dev/sda1        40G   38G  1.2G  97% /
$ df -i /
Filesystem      Inodes  IUsed   IFree IUse% Mounted on
/dev/sda1      2621440 2621440      0  100% /
WarningUne sortie
df -hrassurante n'exclut pas un disque plein. Vérifiez toujoursdf -iégalement : un épuisement des inodes fait échouer les écritures exactement comme un manque d'octets, mais un disque plus grand ne résoudra rien. Supprimer les petits fichiers, si.
Par défaut, les systèmes de fichiers ext4 réservent aussi environ 5 % des blocs à root (tune2fs -m), ce qui explique pourquoi df -h affiche parfois un système de fichiers comme « plein » pour les utilisateurs ordinaires un peu avant qu'il ne le soit réellement : cette marge permet aux processus système de continuer à écrire un peu plus longtemps.
Dans tous les cas, le signal utile est le même que pour la mémoire : un disque qui grossit à un rythme régulier et atteindra sa limite dans un nombre de jours connu est un problème que l'on peut planifier, au lieu d'un problème qui vous réveille à 3 h du matin.
Surveiller les trois sans avoir à y penser
Lancer manuellement dmesg, free et df -i sur chacun de vos serveurs ne tient plus au-delà de quelques machines, et suppose que quelqu'un pense à vérifier avant que le problème ne frappe. Le monitoring d'InfraNest surveille précisément ces trois problèmes à évolution lente sur chaque serveur équipé de son agent, et affiche chacun d'eux sur votre page d'accueil, sur la page du serveur ou du volume concerné et dans la vue d'ensemble des serveurs, au lieu de le laisser enfoui dans une ligne de log.
Pour une fuite, il nomme le service ou le conteneur précis dont la mémoire ne cesse d'augmenter, dès que le même schéma de hausse puis de retombée est apparu sur au moins deux redémarrages. Pour les OOM kills, il signale un serveur dès que trois processus ou plus ont été tués de cette façon en une semaine, et vous indique directement ce qui consomme le plus de mémoire. Pour un volume qui se remplit, il extrapole le rythme actuel et le liste dès qu'il est en passe d'être plein d'ici deux semaines ; l'alerte s'affiche sur le volume lui-même s'il s'agit d'un volume cloud, puisque c'est lui que vous agrandiriez.
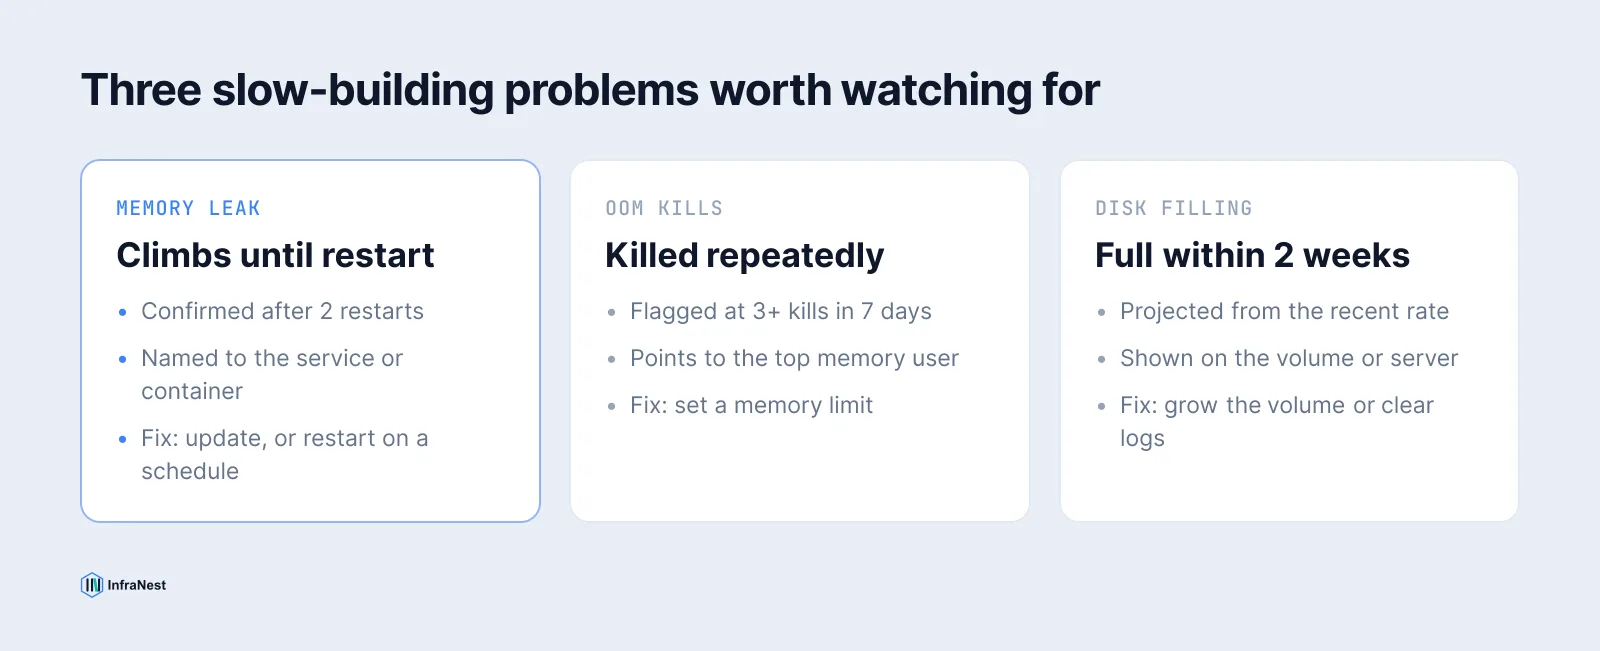
Cette prévision ne fonctionne que parce qu'elle compare les derniers jours, et non une mesure isolée : c'est le même principe que celui de la lecture des tendances par rapport aux pics ponctuels dans les métriques serveur en général, et celui d'un monitoring de sites web et de serveurs qui détecte réellement les défaillances lentes, et pas seulement les pannes.
Corriger : gagner du temps, puis traiter la cause
- Fuite mémoire : redémarrer le service concerné de façon planifiée (la nuit, par exemple) permet de gagner du temps sans redémarrer tout le serveur, pendant que vous déployez le vrai correctif, qui se résume souvent à une simple mise à jour.
- OOM kills répétés : imposez une limite mémoire stricte au pire coupable pour qu'il échoue de façon prévisible, ou ajoutez de la mémoire au serveur si rien ne semble manifestement dysfonctionner.
- Disque qui se remplit : agrandissez le volume s'il s'agit d'un disque cloud, ou supprimez les coupables habituels (anciens logs, sauvegardes, files d'attente bloquées) s'il est local.
- Inodes épuisés : un disque plus grand aide rarement ; trouvez plutôt le dossier qui génère le plus de petits fichiers et faites-y le ménage.
Aucun de ces problèmes n'est une urgence si vous le repérez une semaine à l'avance. Tous le deviennent si vous le découvrez alors que le disque est déjà plein ou que le service est déjà tombé.
Si vous mettez cela en place pour un parc de machines plutôt que pour un seul serveur, affichez vos serveurs avec leurs sondes de surveillance, afin qu'une fuite lente sur une machine ne demande pas une investigation distincte de la panne qu'elle finit par provoquer.
Prêt à ne plus l'apprendre par un client ? Configurez le monitoring de vos serveurs et laissez-le signaler la fuite, la série d'OOM kills et le disque qui se remplit avant qu'ils ne provoquent une panne.
Questions fréquentes
#Combien de redémarrages faut-il pour confirmer une fuite mémoire ?
Une hausse isolée de la mémoire ne suffit pas : une semaine chargée peut ressembler à une fuite. Le signal fiable est la répétition du même schéma de hausse puis de retombée sur au moins deux redémarrages du service ou du serveur, avec une mémoire qui revient systématiquement à un niveau de base à chaque fois.
#Pourquoi un disque affiche-t-il de l'espace libre tout en refusant les écritures ?
Le disque est probablement à court d'inodes, et non d'octets. Chaque fichier utilise un inode quelle que soit sa taille, si bien qu'un disque rempli de petits fichiers, comme des entrées de cache ou des données de session, peut afficher beaucoup d'espace libre dans df -h alors que df -i indique 100 % d'utilisation.
#Quel code de sortie indique qu'un processus a été tué par manque de mémoire ?
Sous Linux, un processus tué par l'OOM killer se termine généralement avec le code 137 (128 plus le signal 9, SIGKILL). Dans Kubernetes, le statut du pod affiche en outre OOMKilled pour le même événement.
#Faut-il installer quelque chose sur le serveur pour détecter ces problèmes ?
La mémoire, l'espace disque et l'historique des OOM kills ne sont généralement pas exposés par l'API du fournisseur cloud. Pour les détecter de manière fiable, il faut donc un agent installé sur le serveur lui-même plutôt que de se fier uniquement aux métriques du fournisseur.
Essayez avec un outil gratuit
Cet article vous a-t-il été utile ?