Pendant un incident, une bonne page de statut dit quatre choses, dans cet ordre : ce qui est touché, la gravité, ce que vous savez à cet instant et quand vous donnerez des nouvelles. Elle ne dit pas qui est d'astreinte, quel serveur dysfonctionne, et ne renvoie pas vers votre runbook interne. Ces informations ont leur place ailleurs : les publier sur la page publique risque soit de dérouter les clients, soit de divulguer des détails que vous n'aviez pas l'intention de partager.
La plupart des équipes réussissent la partie publique, mais ne règlent jamais la seconde : où mettre, à la place, les informations destinées aux intervenants ? Cet article traite des deux.
Ce que les clients ont vraiment besoin de lire
Une mise à jour de page de statut est utile si un lecteur stressé et non technique peut répondre en cinq secondes à la question « suis-je concerné, et quand sera-ce réparé ? ». Cela suppose :
- Les services touchés, nommés comme les clients les connaissent (« Paiement », pas « payments-worker-3 »).
- La gravité actuelle, exprimée simplement : performances dégradées, panne partielle ou panne majeure, et non une priorité de ticket interne.
- Ce que vous savez à ce stade, en langage clair, sans jargon interne ni recherche de coupable.
- L'heure de la prochaine mise à jour, même si celle-ci se résume à « toujours en cours d'investigation ».
La plupart des pages de statut (y compris celles des grands acteurs : les pages de statut de GitHub et de Cloudflare suivent toutes deux ce modèle) font passer un incident par un petit nombre d'états au fil de son évolution :
| État | Ce qu'il indique au lecteur |
|---|---|
| Investigation en cours | Quelque chose ne va pas ; nous en confirmons l'étendue |
| Identifié | Nous connaissons la cause |
| Sous surveillance | Un correctif est en place ; nous vérifions qu'il tient |
| Résolu | C'est terminé |
Il ne s'agit pas d'une norme officielle (aucune RFC ne régit la formulation des pages de statut), mais c'est une convention qui mérite d'être suivie, car vos clients ont déjà appris à la lire sur tous les autres outils SaaS qu'ils utilisent. Réinventer le vocabulaire ne fait qu'ajouter de la friction au moment précis où les gens veulent de la clarté.
TipPubliez une mise à jour à intervalle fixe, même « aucun changement, investigation toujours en cours », plutôt que de rester silencieux entre deux étapes. Le silence donne une impression d'abandon, même quand le travail se poursuit activement en coulisses.
Pourquoi la version destinée aux clients ne convient pas à votre équipe
Voici le problème : la page rédigée pour les clients est volontairement incomplète. C'est ce qu'il leur faut, mais c'est inutile pour la personne qui corrige réellement le problème. Un intervenant alerté à 3 h du matin ne veut pas lire « nous enquêtons sur un problème de paiement » : il veut savoir quelles régions le signalent, de quand date la dernière vérification, qui d'autre est déjà dessus et où se trouve le runbook de ce service précis.
Aujourd'hui, les équipes résolvent ce problème en conservant ces informations à un tout autre endroit (une page wiki, un message épinglé sur Slack, un tableur des personnes d'astreinte) en espérant que la personne alertée les trouvera assez vite. C'est la lacune qu'aucune page de statut n'a jamais comblée : elle informe les clients qu'il y a une panne, mais elle n'a jamais été conçue pour indiquer à votre propre équipe comment la réparer.
Ce qu'une page de statut devrait plutôt montrer à votre équipe
Une page de statut dispose déjà du signal brut : elle repose sur vos contrôles de monitoring et sait donc exactement quel service est en panne, quelles régions remontent encore des données et depuis combien de temps. Ce qui manque, ce n'est pas davantage de monitoring, mais une seconde lecture de la même page, rédigée pour les personnes qui corrigent le problème plutôt que pour celles qui le subissent.
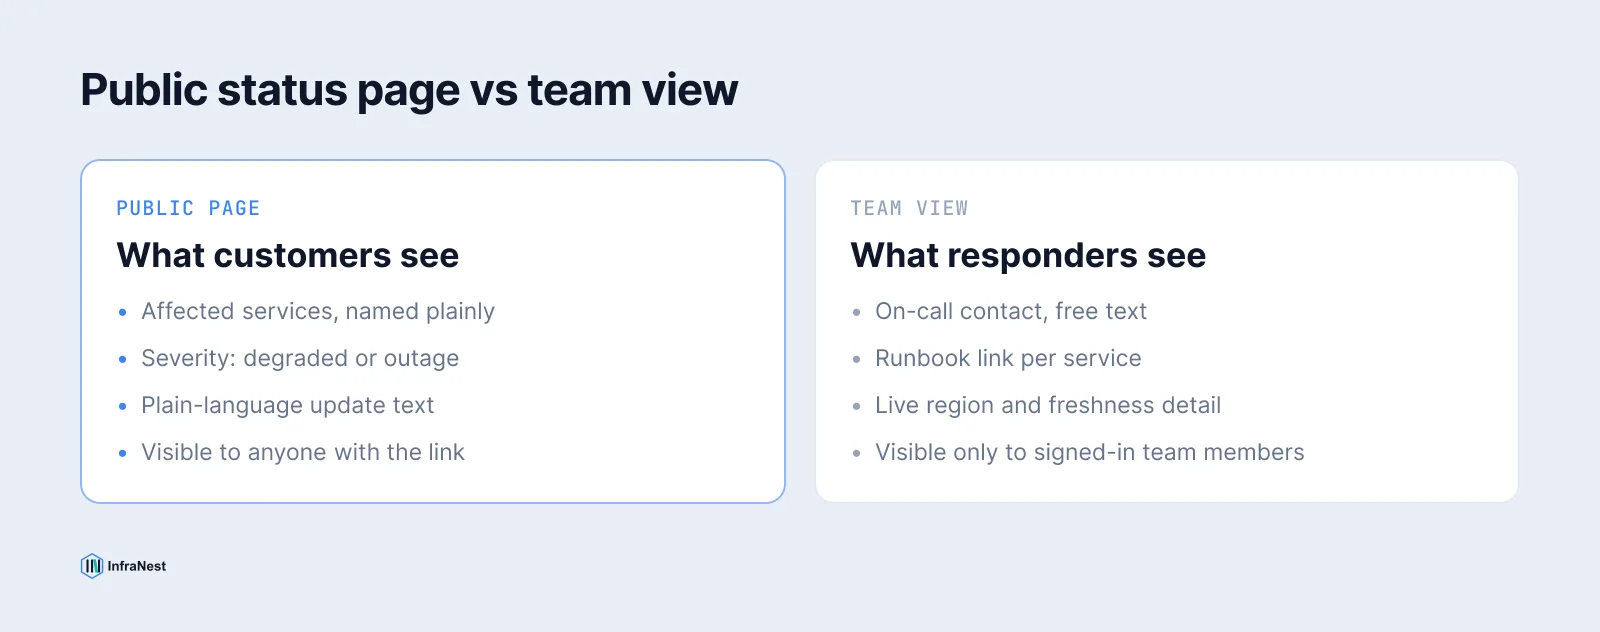
C'est précisément la Team view d'InfraNest. Ouvrez n'importe quelle page de statut : une seconde vue est disponible, derrière votre connexion habituelle, qui affiche :
- Le bandeau supérieur : statut global, nombre de services de la page opérationnels, disponibilité sur 30 jours et début de la prochaine fenêtre de maintenance.
- Astreinte : un champ de texte libre, car la gestion d'un planning d'astreinte est un produit à part entière ; la plupart des équipes ont simplement besoin d'un nom, d'un numéro et d'un canal.
- En cours : tous les incidents actuellement ouverts, chacun avec un lien vers son compte rendu public, c'est-à-dire le lien que vous collez réellement dans un ticket de support.
- Services, 30 derniers jours : regroupés exactement comme les clients les voient, avec des barres de disponibilité, l'heure de la dernière vérification de chacun, le nombre de régions de monitoring qui remontent encore des données et un bouton Runbook pour chaque service qui en possède un.
Ni le contact d'astreinte ni les liens vers les runbooks n'apparaissent jamais sur la page publique. Ils ne sont transmis qu'aux personnes connectées à votre organisation : un client qui connaîtrait le mot de passe de votre page ne verra donc que la page publique, rien de plus. La vue s'actualise aussi automatiquement toutes les 30 secondes, vous pouvez donc la laisser ouverte sur un second écran pendant toute la durée de l'incident.
Configuration
Les deux éléments se configurent au même endroit que la page de statut elle-même :
- Rendez-vous dans Status Pages et ouvrez la page.
- Renseignez On-call contact : un nom, un numéro de téléphone, un lien vers votre planning PagerDuty ou un canal Slack. Videz ce champ quand une personne quitte l'astreinte : un nom obsolète à cet endroit, c'est ainsi que la personne d'astreinte du trimestre dernier continue d'être alertée.
- Ouvrez l'onglet Components, cliquez sur un service et renseignez Runbook link. Faites-le pointer vers le document de ce service, pas vers la page d'accueil de votre wiki : tout l'intérêt est que la personne alertée arrive sur la bonne page, et non sur un index où elle devrait chercher.
Le lien vers le runbook doit commencer par https://. Ces deux éléments font partie des pages de statut privées : si votre offre n'inclut pas la vue équipe, la page vous l'indique et tout le reste continue de fonctionner comme avant.
Exemple d'incident, raconté de deux façons
Le même incident, pour deux publics :
Page publique (destinée aux clients) :
Investigation en cours — Nous constatons un taux d'erreur élevé sur le Paiement. Nous examinons le problème et publierons une mise à jour d'ici 30 minutes.
Vue équipe (au même moment) :
Paiement : 2 régions sur 3 signalent une panne, dernière vérification il y a 14 s. Astreinte : Priya, +44 7xxx, #incidents. Runbook : checkout-5xx-playbook.
La première version est calme, exacte et donne au client exactement les informations dont il a besoin. La seconde est dense, précise et permet à un intervenant d'agir sans le moindre message Slack demandant « quelqu'un sait qui gère ça ? ».
WarningNe collez pas de détails internes (noms de serveurs, nombre de régions, noms des personnes d'astreinte) dans la mise à jour publique de l'incident. Cela n'aide pas le lecteur et c'est un élément de plus à masquer plus tard si la page est un jour partagée à l'extérieur.
Une fois l'incident résolu, le compte rendu public conserve sa propre URL permanente, ce qui est utile, car les tickets de support qui y font référence restent souvent ouverts bien après que la page est passée à autre chose. Si vous transmettez ces liens à votre outil de ticketing, consultez relier les incidents de la page de statut aux échanges avec le support.
Checklist de configuration rapide
- Une page de statut construite à partir de vos vrais moniteurs, pas saisie à la main : voir créer une page de statut.
- Un contact d'astreinte renseigné sur la page et tenu à jour.
- Un lien vers le runbook pour chaque service qui en possède un.
- Une fréquence de mise à jour fixe convenue avec votre équipe, y compris pour les mises à jour « pas encore de changement ».
Questions fréquentes
Vous voulez avoir une vue d'ensemble avant d'en configurer une ? Commencez par les pages de statut.
Questions fréquentes
#Quel est le cycle de vie standard d'un incident sur une page de statut ?
La plupart des pages de statut, dont celles de GitHub et de Cloudflare, font passer un incident par les états Investigation en cours, Identifié, Sous surveillance et Résolu. Il s'agit d'une convention largement suivie plutôt que d'une norme officielle : aucune RFC ne régit la formulation des pages de statut.
#À quelle fréquence publier des mises à jour pendant un incident ?
Assez souvent pour que le silence ne passe jamais pour de l'abandon. Beaucoup d'équipes visent un intervalle fixe, par exemple toutes les 30 minutes, même quand il n'y a rien de nouveau, car « investigation toujours en cours » vaut mieux que pas de mise à jour du tout.
#Quelle est la différence entre une page de statut et une vue équipe ?
Une page de statut est publique et répond à une seule question pour les clients : quelque chose est-il en panne ? Une vue équipe est la même page réécrite pour les intervenants : elle indique qui est d'astreinte, les incidents ouverts et les liens vers le runbook de chaque service, et rien de tout cela n'apparaît jamais sur la page publique.
#Les clients peuvent-ils voir le contact d'astreinte ou les liens vers les runbooks ?
Non. Dans InfraNest, ces deux éléments ne sont transmis qu'aux personnes connectées à votre organisation. Une personne qui connaît le mot de passe d'une page protégée ne voit toujours que la page publique, jamais la vue équipe.
Essayez avec un outil gratuit
Cet article vous a-t-il été utile ?