

Si vous vous êtes déjà demandé pourquoi InfraNest vous a prévenu d’un problème — ou pourquoi il est resté silencieux alors que vous vous y attendiez — cet article est pour vous. Il explique la liste complète des alertes que vous pouvez activer, ce que chacune surveille réellement, et comment ajuster les chiffres sans avoir besoin d’être un expert.
#Vue d’ensemble
- Les réglages d’alerte par défaut constituent la liste complète de tout ce qu’InfraNest peut vous signaler, chacune avec son propre interrupteur.
- Activer une alerte l’applique à tous les serveurs que vous surveillez. Vous pouvez toujours définir des valeurs différentes pour un serveur donné sans affecter les autres.
- Rien n’a besoin d’être créé — la liste est déjà complète, et chaque alerte démarre avec une valeur raisonnable, de sorte que vous n’ayez pas à deviner les seuils vous-même.
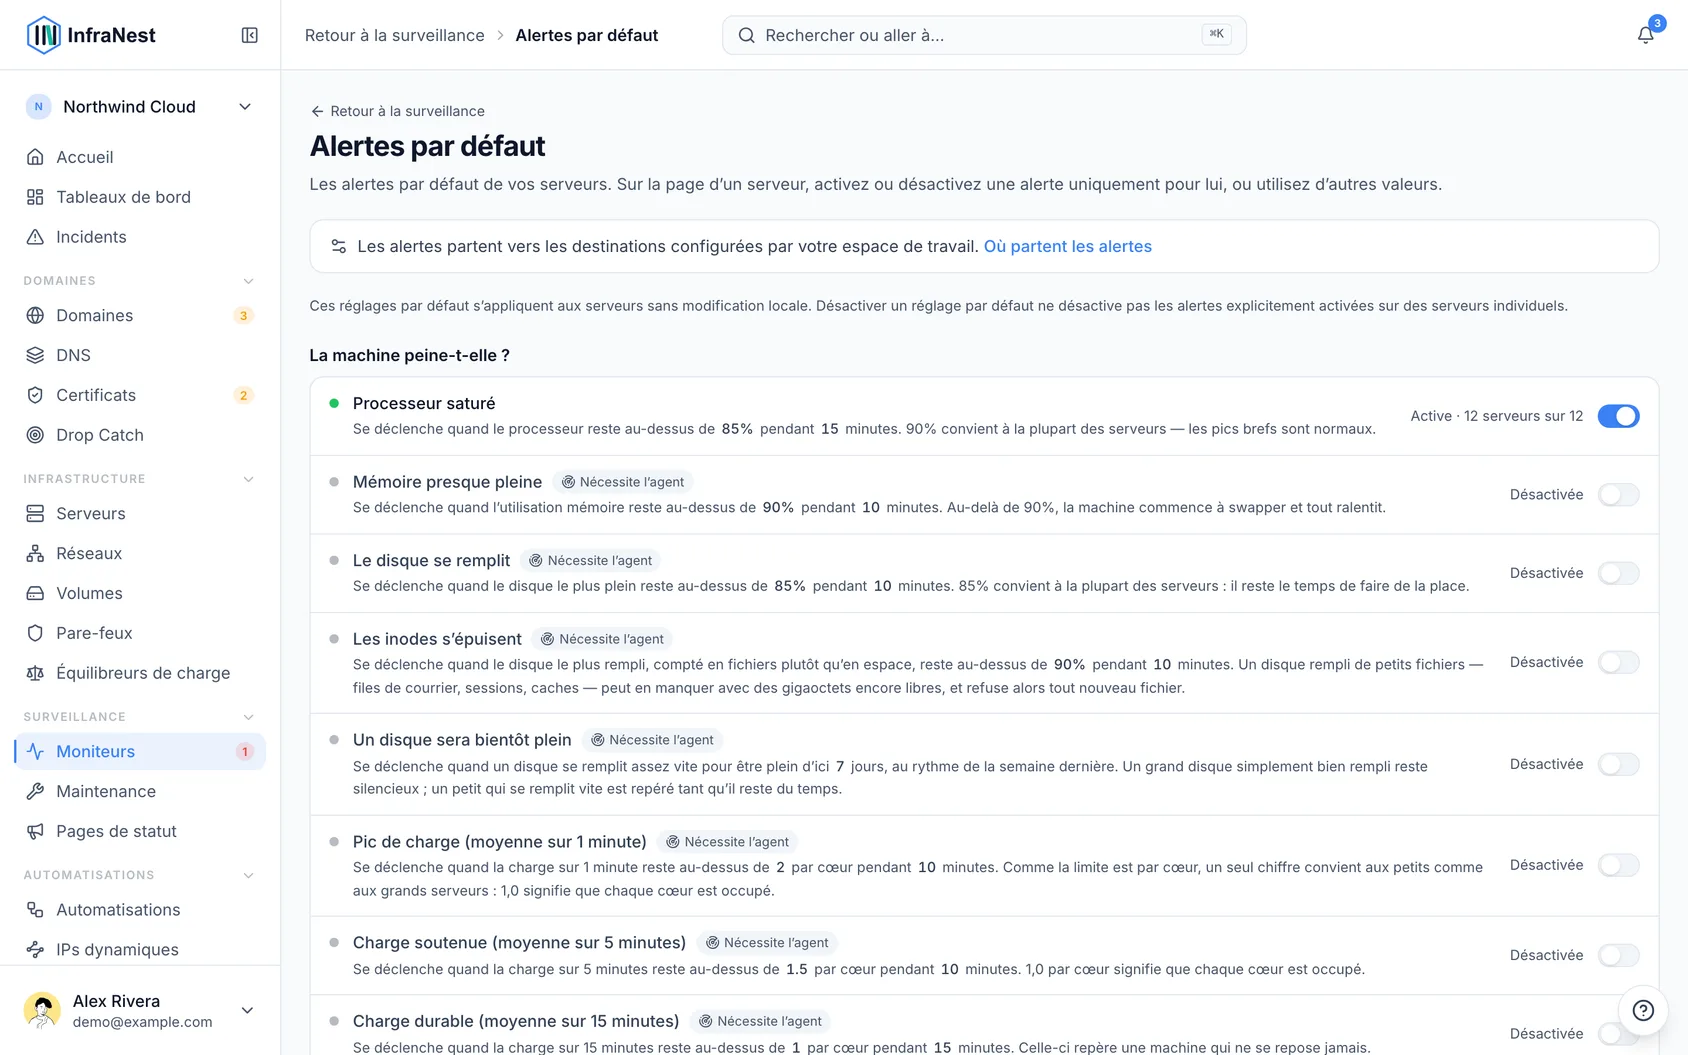
#Activer une alerte
- Allez dans Moniteurs, cliquez sur ⋯ en haut à droite et choisissez Alert defaults.
- Trouvez l’alerte que vous voulez et basculez son interrupteur. C’est toute l’opération — elle est enregistrée immédiatement, et tous les serveurs surveillés commencent à la suivre.
La liste est regroupée en quatre questions :
- La machine est-elle en difficulté ? — CPU, mémoire, espace disque et charge moyenne.
- Quelque chose est-il cassé ? — un service qui a échoué, un service ou un conteneur qui redémarre sans cesse, un processus que le serveur a arrêté par manque de mémoire, et un serveur devenu silencieux.
- Est-ce à jour ? — des mises à jour de sécurité en attente, un redémarrage que le serveur doit effectuer pour terminer l’installation des mises à jour, et un abonnement Ubuntu Pro qui ne couvre plus un serveur.
- Le trafic est-il inhabituel ? — débit réseau et disque. La plupart des gens laissent ces alertes désactivées tant qu’ils ne savent pas à quoi ressemble la normale pour un serveur donné. Elles fonctionnent sur tout serveur équipé de l’agent (version 0.14 ou plus récente), et sur les serveurs dont le fournisseur remonte le trafic.
#Modifier un chiffre
Les chiffres font partie de la phrase sous le nom de chaque alerte. Cliquez sur l’un d’eux, saisissez une nouvelle valeur, puis appuyez sur Entrée ou cliquez ailleurs. Il n’y a pas de bouton d’enregistrement et rien à ouvrir.
Deux chiffres par alerte :
- Le seuil — jusqu’où la valeur mesurée doit monter.
- Les minutes — combien de temps elle doit y rester avant que quelqu’un en soit informé.
Ce second chiffre compte plus qu’il n’y paraît. Une durée très courte transforme chaque pic bref en alerte, et les alertes sur lesquelles personne ne peut agir sont celles que l’on commence à ignorer. Dix minutes est un bon point de départ pour la plupart des cas.
TipSi votre forfait enregistre les mesures moins fréquemment que la fenêtre choisie, InfraNest ne vous laissera pas définir une fenêtre trop courte pour être évaluée — la règle ne se déclencherait tout simplement jamais.
La pression CPU, mémoire et E/S mesure quelque chose que la charge seule ne peut pas montrer : la part de chaque minute que les programmes ont passée à attendre — un processeur, de la mémoire libérée, ou le disque. La pression mémoire est souvent le premier signe qu’un serveur est sur le point de manquer de ressources, avant même qu’un processus ne soit arrêté ; la pression E/S révèle un disque lent avant tout autre indicateur. Ces alertes sont nouvelles, leurs valeurs de départ sont donc approximatives — ajustez-les une fois que vous avez observé ce qui est normal pour vos serveurs. Elles nécessitent l’agent en version 0.14 ou plus récente et un noyau Linux raisonnablement récent.
La charge est définie par cœur de CPU. La charge comptabilise le travail en attente d’un processeur, donc le même chiffre signifie quelque chose de différent sur un petit et un grand serveur : 2 correspond à un serveur à deux cœurs totalement occupé, et à un serveur à huit cœurs occupé au quart. Une limite de 1,0 par cœur signifie « chaque cœur occupé », quel que soit le serveur, donc un seul réglage convient à tout votre parc. InfraNest utilise le nombre de cœurs rapporté par l’agent, ou celui du forfait de votre fournisseur, et l’alerte vous indique les deux : « limite 8 (1 par cœur × 8 cœurs) ». Si aucun des deux n’est connu, le serveur est considéré comme n’ayant qu’un seul cœur.
Le serveur est devenu silencieux a son propre minimum, pour la raison inverse. L’agent se manifeste selon le calendrier de votre forfait, donc entre deux contrôles parfaitement normaux, un serveur en bonne santé peut rester silencieux pendant quelques minutes. Le minimum que vous pouvez définir est de cinq minutes, ou trois contrôles manqués sur un forfait qui rapporte moins fréquemment. Si une limite plus courte avait été définie auparavant, ou si votre forfait a changé depuis, l’alerte attend ce minimum de toute façon, et la page affiche le chiffre réellement utilisé.
#Un disque qui manque de fichiers plutôt que d’espace
Le disque manque d’inodes surveille quelque chose que l’alerte d’espace disque ne peut pas voir. Chaque fichier sur un disque utilise un inode, et la plupart des disques en ont un nombre fixe. Un disque rempli de petits fichiers — files d’attente de courrier, sessions PHP, répertoires de cache — peut tous les épuiser alors qu’il reste encore des gigaoctets libres, et à partir de là, il refuse tout nouveau fichier alors que le chiffre d’espace disque indique que tout va bien. Cette alerte se déclenche lorsque le disque le plus plein, compté en fichiers, reste au-dessus de 90 %. La carte Disque du serveur affiche ce chiffre sous un disque une fois qu’il est à moitié utilisé.
Certains systèmes de fichiers, comme btrfs, n’ont pas de nombre fixe d’inodes et ne tombent jamais à court de cette façon ; sur ceux-ci, l’alerte reste silencieuse. Elle nécessite l’agent en version 0.13 ou plus récente.
#Un disque qui sera bientôt plein
Un disque sera bientôt plein répond à la question à laquelle le pourcentage d’espace disque ne fait qu’indirectement allusion : non pas « à quel point est-il plein » mais « quand sera-t-il plein ». InfraNest examine la vitesse à laquelle chaque disque s’est rempli au cours de la dernière semaine — la même prévision que celle affichée par la carte Disque du serveur — et vous prévient une fois lorsqu’un disque est en voie d’être plein dans le nombre de jours que vous avez choisi (une semaine, au départ). Un grand disque qui reste à 88 % pendant des mois reste silencieux ; un petit disque qui se remplit de quelques pourcents par jour est détecté alors qu’il reste encore le temps d’agir. Lorsque le disque cesse de se remplir, ou ralentit largement en dessous de votre limite, vous en êtes également informé.
Elle nécessite l’agent, qui conserve l’historique par disque à partir duquel la prévision est établie.
#Mises à jour et redémarrages
Les deux alertes sous Est-ce à jour ? fonctionnent un peu différemment des autres, car ce qu’elles surveillent peut légitimement prendre du temps.
- Des mises à jour de sécurité sont en attente est mesurée en heures : « plus de 0, pendant 24 heures » au départ, et elle se résorbe dès que le serveur est corrigé. Sur un serveur qui installe les mises à jour lui-même, certaines sont volontairement retardées de quelques jours, donc dans ce cas vous n’êtes prévenu qu’une fois les mises à jour en attente depuis une semaine. Cela signifie généralement que les mises à jour automatiques elles-mêmes se sont arrêtées.
- Un redémarrage est en attente est mesurée en jours. Vous êtes prévenu une fois, lorsqu’un serveur attend un redémarrage depuis plus longtemps que le nombre de jours que vous avez choisi — une semaine, au départ. Un redémarrage survenu dans ce délai, comme le redémarrage nocturne automatique que font de nombreux serveurs Ubuntu, ne déclenche rien du tout. La page du serveur affiche un redémarrage en attente dès qu’il apparaît. Si le serveur redémarre lui-même après les mises à jour, vous êtes prévenu le matin suivant s’il aurait dû redémarrer et ne l’a pas fait. La page du serveur indique comment il est configuré, sous Automatic updates. Tant qu’il n’a pas redémarré, les programmes déjà en cours d’exécution continuent d’utiliser l’ancienne version, y compris tout correctif de sécurité qui vient d’être installé.
Des mises à jour de sécurité sont en attente s’appuie sur des informations que seuls Debian et Ubuntu conservent sur eux-mêmes, donc sur les autres systèmes elle reste silencieuse. Un redémarrage est en attente fonctionne sur tout serveur Linux équipé d’un agent à jour : Debian, Ubuntu et SUSE le signalent eux-mêmes, et sur les autres (Red Hat, Rocky, Alma, Fedora), InfraNest détecte qu’un noyau plus récent a été installé mais n’est pas encore en cours d’exécution. La page du serveur indique lequel des deux cas s’applique. Les serveurs Windows le signalent aussi, via Windows Update et la gestion des composants propre à Windows, de même que leurs services automatiques pour Un service surveillé a échoué — un service arrêté avec une erreur compte, un service arrêté volontairement non. Arch fait exception : il supprime les fichiers du noyau en cours d’exécution lors d’une mise à jour, il n’y a donc plus rien à comparer et l’alerte reste silencieuse.
#Quand une grappe RAID perd un disque
Les serveurs dédiés conservent généralement leurs données sur deux disques à la fois (RAID 1 logiciel), afin que l’un puisse tomber en panne sans rien perdre. Lorsque cela arrive, le serveur continue de fonctionner sur l’autre — ce qui explique exactement pourquoi personne ne le remarque, jusqu’à ce que le second disque tombe également en panne et que les données disparaissent avec lui. Une grappe RAID a perdu un disque vous prévient lorsqu’une grappe fonctionne avec moins de disques que prévu depuis un quart d’heure, et de nouveau lorsqu’elle est complète. Si un disque de remplacement est déjà en cours de remplissage, le message indique son avancement. La carte Système du serveur liste chaque grappe sous RAID.
Les serveurs sans RAID logiciel — la plupart des serveurs cloud — n’ont rien à signaler, et l’alerte reste silencieuse. Elle nécessite l’agent en version 0.14 ou plus récente.
#Quand l’horloge d’un serveur cesse d’être synchronisée
L’horloge a cessé de se synchroniser vous prévient lorsqu’un serveur dont l’horloge était maintenue synchronisée ne l’est plus depuis une demi-heure. Une horloge qui dérive silencieusement casse les codes à deux facteurs, les vérifications de certificats, les tâches planifiées et les horodatages de chaque journal, bien avant que la dérive ne soit suffisamment importante pour que quiconque le remarque. La carte Système du serveur affiche l’état de l’horloge sous Clock.
Certains serveurs ne signalent jamais leur horloge comme synchronisée et c’est normal — la plateforme d’hébergement maintient elle-même l’heure correcte. Cette alerte ne se prononce que pour un serveur qu’elle a vu synchronisé, donc ceux-là restent silencieux. Elle nécessite l’agent en version 0.14 ou plus récente.
#Quand Ubuntu Pro ne couvre plus un serveur
Ubuntu Pro a expiré vous prévient lorsqu’un serveur qui était rattaché à Ubuntu Pro ne l’est plus, parce que quelqu’un l’a détaché ou que l’abonnement est arrivé à expiration. Livepatch et les mises à jour de sécurité supplémentaires (ESM) s’arrêtent à ce moment-là, et le serveur lui-même ne le signale nulle part.
Vous êtes prévenu une fois que le serveur est sans Ubuntu Pro depuis le nombre de minutes que vous avez choisi (une heure, au départ), afin que le détacher puis le rattacher immédiatement ne déclenche rien. Lorsque le serveur est de nouveau couvert, vous recevez un message de résolution.
Les serveurs qui n’ont jamais eu Ubuntu Pro sont laissés tranquilles. La carte System du serveur affiche la même chose : si le serveur est rattaché, et si Livepatch et ESM sont activés. Cela nécessite l’agent en version 0.11.0 ou plus récente.
#Quand un serveur manque de mémoire
Le serveur a manqué de mémoire vous prévient lorsqu’un serveur est tombé si bas en mémoire qu’il a dû arrêter un programme pour continuer à fonctionner. Le graphique de mémoire ne peut pas montrer cela : c’est l’arrêt du programme qui a libéré la mémoire, donc la mesure suivante paraît saine. Cette alerte est le seul endroit où cela apparaît.
Vous êtes prévenu une fois, même si plusieurs programmes sont arrêtés à la suite. Lorsque plus rien n’a été arrêté depuis le nombre de minutes que vous avez choisi (une heure, au départ), vous recevez un message de résolution. L’e-mail indique la commande à exécuter sur le serveur pour voir quel était le programme concerné.
La carte System du serveur affiche aussi combien de programmes ont été arrêtés de cette façon depuis le dernier démarrage du serveur, et quand c’est arrivé pour la dernière fois. Elle nécessite l’agent en version 0.10.0 ou plus récente.
#Quand un service redémarre sans cesse
Un service redémarre sans cesse vous prévient lorsqu’un service sur un serveur ne cesse de planter et d’être relancé. Le serveur le relance immédiatement à chaque fois, donc chaque fois que vous regardez, il affiche « en cours d’exécution » — mais il ne cesse de tomber en panne, et tout ce qu’il était en train de faire est interrompu à chaque fois.
Elle démarre à 3 redémarrages en 15 minutes : un redémarrage est un incident ponctuel que le serveur a géré, trois en un quart d’heure constituent un schéma récurrent. Les deux chiffres figurent dans la phrase et vous pouvez les modifier. Seuls les redémarrages effectués par le serveur lui-même comptent — redémarrer un service vous-même, ou un déploiement qui le fait, ne déclenche jamais cette alerte.
Vous êtes prévenu une fois, avec le nom du service et le nombre de fois qu’il a redémarré. Lorsque rien n’a redémarré pendant la durée de la fenêtre, vous recevez un message de résolution. Un service que vous avez choisi d’ignorer sur un serveur ne déclenche pas non plus cette alerte.
#Quand un conteneur redémarre sans cesse
Un conteneur redémarre sans cesse est la même alerte pour les conteneurs Docker et Podman. Un conteneur qui ne cesse de planter est relancé à chaque fois, donc il apparaît toujours comme actif — cette alerte vous prévient lorsqu’un conteneur redémarre 3 fois en 15 minutes, au départ. Vous pouvez modifier les deux chiffres.
L’alerte nomme le conteneur par son identifiant court, et non par son nom. Pour voir le nom, exécutez une commande de liste des conteneurs sur le serveur. L’agent ne se connecte jamais à Docker lui-même, car cela lui donnerait un contrôle total sur votre serveur, il ne peut donc pas lire les noms.
Vous êtes prévenu une fois, et vous recevez un message de résolution lorsqu’aucun conteneur n’a redémarré pendant la durée de la fenêtre. Les conteneurs ne peuvent pas encore être ignorés individuellement ; pour arrêter cette alerte sur un serveur, désactivez-la pour ce serveur. Elle nécessite la version la plus récente de l’agent, et les serveurs qui exécutent Docker avec son ancien réglage « cgroupfs » ne remontent pas les conteneurs du tout.
#Ce que chaque alerte surveille réellement
Chaque alerte activée indique à combien de serveurs elle s’applique — « On · 12 sur 14 serveurs » — et chacune a une phrase indiquant exactement quand elle se déclenche.
Les alertes marquées Needs agent surveillent quelque chose qu’aucun fournisseur cloud ne remonte. Vous pouvez les activer pour l’espace de travail, mais elles ne se déclenchent que sur les serveurs où l’agent est installé. Sur un serveur qui n’en dispose pas, l’alerte le signale sur la ligne correspondante et propose de l’installer immédiatement.
#Modifier un serveur donné
Ouvrez le serveur depuis Moniteurs → Serveurs et allez dans son onglet Alerts & rules. Vous obtenez la même liste, montrant ce que cette machine fait réellement : Normal, Firing, ou désactivé. Un serveur qui a besoin d’un redémarrage affiche Waiting plutôt que Firing — rien ne cloche, il lui reste simplement quelque chose à faire.
- Les alertes provenant de l’espace de travail sont marquées Org default.
- Modifiez un chiffre ici et il devient Changed here — seul ce serveur est affecté.
- Reset le ramène à la valeur de l’espace de travail.
- Désactiver une alerte sur cette page la désactive uniquement pour ce serveur. Désactiver la valeur par défaut la désactive partout.
NoteUne alerte que votre espace de travail n’a pas du tout activée ne peut pas être activée pour un seul serveur de façon isolée — la ligne le précise et renvoie vers cet article.
#Désactiver une alerte
Rebasculez l’interrupteur. Rien n’est supprimé : les chiffres définis par serveur sont conservés, et ils reprennent effet si vous réactivez l’alerte plus tard.
Cet article vous a-t-il été utile ?
Merci pour votre retour !
Merci, cela va directement à l’équipe docs.