

Als je je ooit hebt afgevraagd waarom InfraNest je ergens voor waarschuwde — of waarom het stil bleef terwijl je dat niet verwachtte — dan is dit artikel voor jou. Het legt de volledige lijst van meldingen uit die je kunt inschakelen, wat elke melding precies in de gaten houdt, en hoe je de waarden kunt aanpassen zonder expert te hoeven zijn.
#Overzicht
- Standaardmeldingen is de volledige lijst van alles waarvoor InfraNest je kan waarschuwen, elk met een eigen schakelaar.
- Als je er een inschakelt, geldt dit voor elke server die je monitort. Je kunt nog steeds andere waarden instellen voor één specifieke server, zonder invloed op de rest.
- Er hoeft niets te worden aangemaakt — de lijst is al compleet en elke melding start met een verstandige waarde, zodat je zelf niet naar drempelwaarden hoeft te gokken.
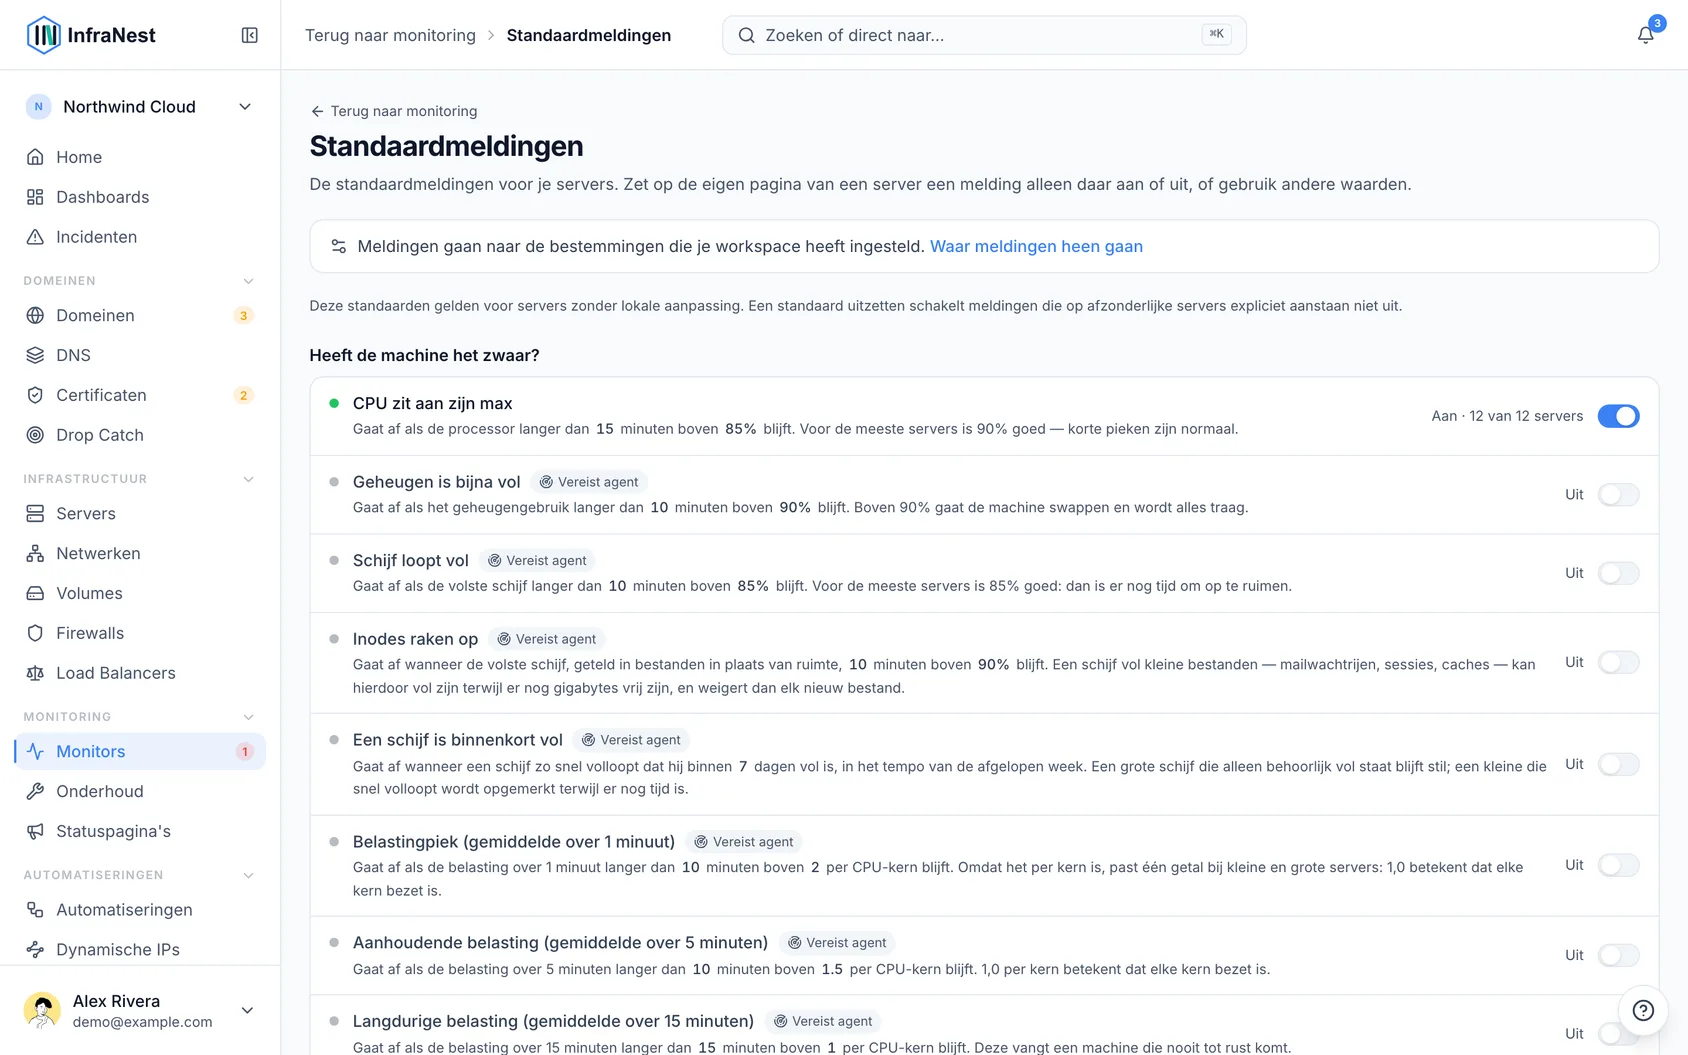
#Een melding inschakelen
- Ga naar Monitoring, klik rechtsboven op ⋯ en kies Alert defaults.
- Zoek de gewenste melding en zet de schakelaar om. Dat is de hele stap — de wijziging wordt direct opgeslagen en elke gemonitorde server volgt deze vanaf dat moment.
De lijst is onderverdeeld in vier vragen:
- Heeft de machine het moeilijk? — CPU, geheugen, schijfruimte en load average.
- Is er iets kapot? — een service die is uitgevallen, een service of container die steeds opnieuw opstart, een proces dat de server heeft beëindigd wegens geheugentekort, en een server die stil is geworden.
- Is alles up-to-date? — wachtende beveiligingsupdates, een herstart die de server nog moet uitvoeren om updates te voltooien, en een Ubuntu Pro-abonnement dat een server niet langer dekt.
- Is het verkeer ongebruikelijk? — netwerk- en schijfdoorvoer. De meeste mensen laten deze uit totdat ze weten wat normaal is voor een specifieke server. Ze werken op elke server met de agent (versie 0.14 of nieuwer), en op servers waarvan de provider verkeer rapporteert.
#Een waarde wijzigen
De waarden maken deel uit van de zin onder de naam van elke melding. Klik op een waarde, typ een nieuwe waarde en druk op Enter of klik ernaast. Er is geen opslaanknop en niets om te openen.
Twee waarden per melding:
- De drempelwaarde — hoe hoog de meting moet oplopen.
- De minuten — hoe lang dit moet aanhouden voordat iemand wordt geïnformeerd.
Dat tweede getal is belangrijker dan het lijkt. Een zeer korte duur maakt van elke korte piek een melding, en meldingen waar niemand iets mee kan beginnen zijn precies de meldingen die mensen gaan negeren. Tien minuten is voor de meeste zaken een verstandig startpunt.
TipAls je abonnement metingen minder vaak opslaat dan de gekozen periode, laat InfraNest je geen periode instellen die te kort is om te beoordelen — de regel zou dan simpelweg nooit afgaan.
CPU-, geheugen- en I/O-druk meten iets wat load niet kan laten zien: hoeveel van elke minuut programma's hebben gewacht — op een processor, op vrijgemaakt geheugen, of op de schijf. Geheugendruk is vaak het eerste teken dat een server door zijn geheugen heen dreigt te raken, nog voordat er iets wordt beëindigd; I/O-druk toont een trage schijf eerder dan wat dan ook. Dit zijn nieuwe meldingen, dus de startwaarden zijn grof — stel ze bij zodra je weet wat normaal is voor jouw servers. Ze vereisen agentversie 0.14 of nieuwer en een redelijk recente Linux-kernel.
Load wordt per CPU-kern ingesteld. Load telt het werk dat wacht op een processor, dus hetzelfde getal betekent iets anders op een kleine en een grote server: 2 betekent een volledig bezette server met twee kernen, en bij een server met acht kernen een kwart bezet. Een limiet van 1,0 per kern betekent \“elke kern bezet\”, ongeacht de server, zodat één instelling past bij je hele serverpark. InfraNest gebruikt het aantal kernen dat de agent rapporteert, of dat van het abonnement van je provider, en de melding vermeldt beide: \“limiet 8 (1 per kern × 8 kernen)\”. Als geen van beide bekend is, wordt de server behandeld alsof hij één kern heeft.
De server is stil geworden heeft een eigen minimum, om de tegenovergestelde reden. De agent meldt zich volgens het schema van je abonnement, dus tussen twee volkomen normale meldingen in kan een gezonde server een paar minuten stil zijn. De kortste instelbare waarde is vijf minuten, of drie gemiste meldingen bij een abonnement dat minder vaak rapporteert. Als er eerder een kortere limiet was ingesteld, of je abonnement is sindsdien gewijzigd, wacht de melding toch op dat minimum en toont de pagina de waarde die daadwerkelijk wordt gebruikt.
#Een schijf die zonder bestanden komt te zitten in plaats van zonder ruimte
Geen inodes meer beschikbaar houdt iets in de gaten dat de schijfruimte-melding niet kan zien. Elk bestand op een schijf gebruikt één inode, en de meeste schijven hebben daar een vast aantal van. Een schijf vol kleine bestanden — mailwachtrijen, PHP-sessies, cachemappen — kan deze allemaal opgebruiken terwijl er nog gigabytes vrij zijn, en vanaf dat moment weigert de schijf elk nieuw bestand terwijl het schijfruimtecijfer zegt dat alles in orde is. Deze melding gaat af wanneer de volste schijf, geteld in bestanden, boven de 90% blijft. De Disk-kaart van de server toont dit cijfer onder een schijf zodra deze voor de helft is gebruikt.
Sommige bestandssystemen, zoals btrfs, hebben geen vast aantal inodes en raken hier nooit zonder te komen; daarop blijft de melding stil. Hiervoor is agentversie 0.13 of nieuwer vereist.
#Een schijf die binnenkort vol raakt
Een schijf raakt binnenkort vol beantwoordt de vraag waar het schijfruimtepercentage slechts een benadering van is: niet \“hoe vol is hij\”, maar \“wanneer raakt hij vol\”. InfraNest kijkt naar hoe snel elke schijf de afgelopen week is gegroeid — dezelfde voorspelling die de Disk-kaart van de server toont — en meldt dit één keer wanneer een schijf op koers ligt om binnen het aantal dagen dat je hebt gekozen (standaard een week) vol te raken. Een grote schijf die maandenlang op 88% blijft staan, blijft stil; een kleine schijf die enkele procenten per dag vult, wordt gesignaleerd terwijl er nog tijd is om in te grijpen. Wanneer een schijf stopt met vullen, of dit ruim onder je limiet vertraagt, word je daar ook over geïnformeerd.
Hiervoor is de agent vereist, die de geschiedenis per schijf bijhoudt waarop de voorspelling is gebaseerd.
#Updates en herstarts
De twee meldingen onder Is alles up-to-date? werken iets anders dan de rest, omdat wat ze in de gaten houden best een tijdje mag duren.
- Beveiligingsupdates wachten wordt gemeten in uren: standaard \“meer dan 0, gedurende 24 uur\”, en de melding verdwijnt zodra de server is bijgewerkt. Op een server die updates zelf installeert, worden sommige updates bewust een paar dagen uitgesteld, dus daar word je pas geïnformeerd zodra updates een week hebben gewacht. Dat betekent meestal dat de automatische updates zelf zijn gestopt.
- Er staat een herstart gepland wordt gemeten in dagen. Je wordt één keer geïnformeerd, wanneer een server langer dan het aantal dagen dat je hebt gekozen (standaard een week) op een herstart wacht. Een herstart binnen die tijd, zoals de automatische nachtelijke herstart die veel Ubuntu-servers uitvoeren, stuurt helemaal niets. De pagina van de server toont een geplande herstart vanaf het moment dat deze zich voordoet. Als de server zichzelf herstart na updates, word je de ochtend erna geïnformeerd als dat niet is gebeurd terwijl het wel had moeten gebeuren. De pagina van de server toont hoe dit is ingesteld, onder Automatische updates. Totdat de server herstart, blijven al draaiende programma's de oude versie gebruiken, inclusief elke beveiligingsfix die net is geïnstalleerd.
Beveiligingsupdates wachten is afhankelijk van informatie die alleen Debian en Ubuntu over zichzelf bijhouden, dus op andere systemen blijft deze melding stil. Er staat een herstart gepland werkt op elke Linux-server met een actuele agent: Debian, Ubuntu en SUSE melden dit zelf, en bij de andere (Red Hat, Rocky, Alma, Fedora) merkt InfraNest dat er een nieuwere kernel is geïnstalleerd die nog niet draait. De pagina van de server vermeldt welke van de twee het was. Windows-servers rapporteren dit ook, via Windows Update en Windows' eigen onderdeelbeheer, net als hun automatische services voor Een gevolgde service is uitgevallen — een service die met een fout is gestopt telt mee, een service die bewust is gestopt niet. Arch is de uitzondering: het verwijdert de bestanden van de draaiende kernel bij een update, waardoor er niets overblijft om mee te vergelijken en de melding stil blijft.
#Wanneer een RAID-array een schijf verliest
Dedicated servers bewaren hun gegevens doorgaans tegelijkertijd op twee schijven (software-RAID 1), zodat één schijf kan uitvallen zonder dat er iets verloren gaat. Als dat gebeurt, blijft de server op de andere schijf doorwerken — en precies daarom merkt niemand het, totdat ook de tweede schijf uitvalt en de gegevens verdwijnen. Een RAID-array heeft een schijf verloren informeert je wanneer een array een kwartier lang op minder schijven draait dan waarvoor hij is opgezet, en opnieuw zodra de array weer compleet is. Als er al een vervangende schijf wordt gevuld, vermeldt het bericht hoe ver dit proces gevorderd is. De System-kaart van de server vermeldt elke array onder RAID.
Servers zonder software-RAID — de meeste cloudservers — hebben niets te rapporteren en de melding blijft stil. Hiervoor is agentversie 0.14 of nieuwer vereist.
#Wanneer de klok van een server niet meer gelijk loopt
De klok synchroniseert niet meer informeert je wanneer de klok van een server die werd gesynchroniseerd, dit al een halfuur niet meer doet. Een klok die geruisloos afwijkt, verstoort tweefactorcodes, certificaatcontroles, geplande taken en de tijdstempels in elk logbestand, lang voordat het verschil groot genoeg is om op te vallen. De System-kaart van de server toont de status van de klok onder Clock.
Sommige servers rapporteren hun klok nooit als gesynchroniseerd, en dat is prima zo — het hostingplatform houdt de tijd zelf correct. Deze melding spreekt zich alleen uit over een server die ooit gesynchroniseerd is gezien, dus die servers blijven stil. Hiervoor is agentversie 0.14 of nieuwer vereist.
#Wanneer Ubuntu Pro een server niet langer dekt
Ubuntu Pro is verlopen informeert je wanneer een server die aan Ubuntu Pro was gekoppeld dat niet langer is, doordat iemand de koppeling heeft verbroken of het abonnement is verlopen. Livepatch en de extra beveiligingsupdates (ESM) stoppen op dat moment, en de server zelf meldt dit nergens.
Je wordt geïnformeerd zodra de server gedurende het aantal minuten dat je hebt gekozen (standaard een uur) zonder Ubuntu Pro zit, zodat het direct ontkoppelen en opnieuw koppelen dit niet meteen activeert. Zodra de server weer gedekt is, krijg je een all-clear-melding.
Servers die nooit Ubuntu Pro hebben gehad, worden met rust gelaten. De System-kaart van de server toont hetzelfde: of de server gekoppeld is, en of Livepatch en ESM aan staan. Hiervoor is agentversie 0.11.0 of nieuwer vereist.
#Wanneer een server zonder geheugen komt te zitten
De server is zonder geheugen komen te zitten informeert je wanneer een server zo weinig geheugen over had dat er een programma moest worden gestopt om door te kunnen gaan. De geheugengrafiek kan dit niet laten zien: het stoppen van het programma is juist wat het geheugen vrijmaakte, waardoor de volgende meting er gezond uitziet. Deze melding is de enige plek waar dit zichtbaar wordt.
Je wordt één keer geïnformeerd, zelfs als er meerdere programma's achter elkaar worden gestopt. Zodra er gedurende het aantal minuten dat je hebt gekozen (standaard een uur) niets meer is gestopt, krijg je een all-clear-melding. De e-mail vermeldt het commando dat je op de server kunt uitvoeren om te zien om welk programma het ging.
De System-kaart van de server toont ook hoeveel programma's op deze manier zijn gestopt sinds de server voor het laatst is opgestart, en wanneer dit voor het laatst gebeurde. Hiervoor is agentversie 0.10.0 of nieuwer vereist.
#Wanneer een service steeds opnieuw opstart
Een service blijft opnieuw opstarten informeert je wanneer één service op een server steeds vastloopt en opnieuw wordt gestart. De server start deze elke keer meteen weer op, dus telkens als je kijkt staat er \“running\” — maar de service blijft vastlopen, en alles waar deze mee bezig was, wordt elke keer afgebroken.
De standaardinstelling is 3 herstarts binnen 15 minuten: één herstart is een hikje dat de server zelf heeft opgelost, drie in een kwartier is een patroon. Beide waarden staan in de zin en kunnen worden gewijzigd. Alleen herstarts die de server zelf heeft uitgevoerd, tellen mee — het zelf herstarten van een service, of een deploy die dit doet, activeert deze melding nooit.
Je wordt één keer geïnformeerd, met de naam van de service en hoe vaak deze is herstart. Zodra er gedurende de ingestelde periode niets meer is herstart, krijg je een all-clear-melding. Een service die je hebt gekozen te negeren op een server, activeert deze melding ook niet.
#Wanneer een container steeds opnieuw opstart
Een container blijft opnieuw opstarten is dezelfde melding voor Docker- en Podman-containers. Een container die steeds vastloopt, wordt elke keer opnieuw gestart, dus deze toont altijd als actief — deze melding informeert je wanneer een container standaard 3 keer binnen 15 minuten herstart. Beide waarden zijn aan te passen.
De melding noemt de container bij zijn korte ID, niet bij zijn naam. Om de naam te zien, voer je een container-list-commando uit op de server. De agent maakt nooit zelf verbinding met Docker, omdat dit volledige controle over je server zou geven, dus kan deze de namen niet lezen.
Je wordt één keer geïnformeerd, en je krijgt een all-clear-melding zodra er gedurende de ingestelde periode geen container meer is herstart. Containers kunnen nog niet afzonderlijk worden genegeerd; om deze melding op één server te stoppen, schakel je deze uit voor die server. Hiervoor is de nieuwste versie van de agent vereist, en servers die Docker draaien met de oudere \“cgroupfs\”-instelling rapporteren helemaal geen containers.
#Wat elke melding precies in de gaten houdt
Elke ingeschakelde melding toont voor hoeveel servers deze geldt — \“Aan · 12 van 14 servers\” — en elke melding heeft een zin die precies aangeeft wanneer deze afgaat.
Meldingen met het label Needs agent houden iets in de gaten dat geen enkele cloudprovider rapporteert. Je kunt ze inschakelen voor de workspace, maar ze gaan alleen af op servers waar de agent is geïnstalleerd. Op een server zonder agent vermeldt de melding dit op de rij en biedt deze meteen de mogelijkheid om de agent daar te installeren.
#Eén server wijzigen
Open de server via Monitoring → Servers en ga naar het tabblad Alerts & rules. Je krijgt dezelfde lijst te zien, met wat die machine daadwerkelijk doet: Normal, Firing, of uitgeschakeld. Een server die een herstart nodig heeft, toont Waiting in plaats van Firing — er is niets mis mee, er staat alleen nog iets te doen.
- Meldingen die van de workspace komen, zijn gemarkeerd als Org default.
- Wijzig een waarde daar en deze wordt Changed here — alleen die server wordt beïnvloed.
- Reset zet de waarde terug naar die van de workspace.
- Het uitschakelen van een melding op die pagina schakelt deze alleen uit voor die server. Het uitschakelen van de standaardinstelling schakelt deze overal uit.
NoteEen melding die je workspace helemaal niet heeft ingeschakeld, kan niet voor één server afzonderlijk worden ingeschakeld — de rij vermeldt dit en verwijst terug naar hier.
#Iets uitschakelen
Zet de schakelaar terug. Er wordt niets verwijderd: eventuele per-server-waarden die mensen hebben ingesteld, blijven bewaard en worden opnieuw actief als je de melding later weer inschakelt.
Was dit artikel nuttig?
Bedankt voor je feedback!
Dank je, dit gaat direct naar het docs-team.