Ein guter Incident-Bericht beantwortet fünf Fragen: Was ist ausgefallen, wie lange hat es gedauert, was ist wann passiert, warum ist es passiert und was änderst du, damit es nicht wieder vorkommt. Schreib ihn noch am selben Tag, an dem du den Incident schließt, nicht drei Wochen später – dann weiß nämlich niemand mehr, welches Deployment zuerst rausging, und ein Bericht, den niemand liest, solange die Details frisch sind, bringt deinem Team nichts bei.
Ein Incident-Bericht ist etwas anderes als das Update für Kunden auf deiner Statusseite. Er ist eine interne Aufzeichnung, meist geschrieben, nachdem der Incident behoben ist, und gedacht für die nächste Person, die wegen etwas Ähnlichem alarmiert wird. Stimmt die Struktur, wird er zum Nachschlagewerk. Stimmt sie nicht – vage, auf Schuldzuweisung ausgerichtet oder gar nicht erst geschrieben –, passiert derselbe Ausfall in sechs Monaten erneut, und niemand erinnert sich daran, dass es ihn schon einmal gab.
Was ist ein Incident-Bericht und warum lohnt er sich?
„Lessons Learned“ ist in den Leitlinien des NIST zur Incident-Behandlung (SP 800-61) buchstäblich eine eigene, benannte Phase: Du behebst nicht nur das Problem, du hältst auch fest, was du künftig anders machen würdest. Das SRE-Buch von Google widmet der Postmortem-Kultur ein ganzes Kapitel, das auf derselben Idee aufbaut – der Bericht ist der Mechanismus, durch den aus einem Ausfall eine Verbesserung wird statt nur ein schlechter Nachmittag.
Die Gewohnheit, die das funktionieren lässt, ist das schuldfreie (blameless) Schreiben – ein Begriff, der auf John Allspaws Arbeit bei Etsy zurückgeht. Der Bericht beschreibt, was das System getan hat und warum die Umstände dieses Verhalten nachvollziehbar gemacht haben, nicht, wer schuld ist. Menschen halten Informationen zurück, wenn sie damit rechnen, dafür verantwortlich gemacht zu werden – und genau diese Informationen braucht ein nützlicher Incident-Bericht.
Was gehört in einen guten Incident-Bericht?
Mindestens sollte ein brauchbarer Incident-Bericht Folgendes abdecken:
| Abschnitt | Welche Frage er beantwortet |
|---|---|
| Auswirkung | Was war betroffen und wem ist es aufgefallen |
| Dauer | Wann hat es begonnen, wann wurde es erkannt, wann wurde es behoben |
| Zeitverlauf | Die wichtigsten Momente der Reihe nach – Deployment, Alarm, Bestätigung, Behebung |
| Wahrscheinliche Ursache | Die plausibelste Erklärung, mit Belegen |
| Beitragende Änderungen | Was sich kurz vorher geändert hat – ein Deployment, eine DNS-Änderung, ein Config-Push |
| Was wir ändern | Die konkreten Folgemaßnahmen, jeweils mit einer verantwortlichen Person |
Schweregrade wie SEV1–SEV4 sind eine nützliche Kurzform dafür, wie dringend etwas einen Bericht braucht, aber es gibt weder einen RFC noch einen Branchenstandard, der sie definiert – das SEV2 jedes Teams bedeutet etwas leicht anderes. Geh also nicht davon aus, dass ein Label allein jemandem außerhalb deines Teams die Auswirkung vermittelt.
TipSchreib den Abschnitt „Was hat sich geändert“, bevor du die Ursache aufschreibst. Bei den meisten Ausfällen ist die Ursache eine kürzliche Änderung – ein Deployment, eine still fehlgeschlagene Zertifikatserneuerung, eine Firewall-Regel, ein abgelaufener DNS-Eintrag. Wenn du dort zuerst nachsiehst, musst du nicht raten.
Interne Notizen vs. Kunden-Updates – nicht verwechseln
Ein Incident-Bericht und ein Update auf der Statusseite richten sich an unterschiedliche Leser und sollten nie dasselbe Dokument sein. Eine Team-Notiz darf „starte die Datenbank neu, bin in 5 zurück“ sagen und intern bleiben. Ein Update auf der Statusseite muss kürzer und klarer sein und darf keine internen Details enthalten, die deine Kunden nicht brauchen – was betroffen ist, ungefähr wann es behoben sein wird, mehr nicht.
Wenn du beides trennst, vermeidest du den typischen Fehler: Entweder liest sich das öffentliche Update wie ein internes Debug-Log, oder der interne Bericht ist für Kunden so geglättet, dass dein eigenes Team nichts daraus lernen kann.
Eine Vorlage für den Incident-Bericht zum Kopieren
Nutze das als Ausgangsstruktur – streich alles, was nicht passt:
## Incident: Checkout API returning 500s

**Impact:** Checkout failed for ~18% of requests
**Duration:** 14:02–14:31 UTC (29 minutes)
**Detected by:** Automated monitoring, 2 minutes after start

### Timeline
- 13:58 — Deploy of api-gateway v2.14 to production
- 14:02 — Error rate alert fires
- 14:04 — On-call acknowledges
- 14:09 — Deploy identified as likely cause
- 14:14 — Rollback started
- 14:31 — Error rate back to baseline

### Likely cause
The v2.14 deploy changed a connection pool default, exhausting
database connections under peak load.

### What we change
- [ ] Add a connection-pool size alert before it's exhausted
- [ ] Add a canary stage before full rollout for api-gateway
- [ ] Document the rollback command in the runbook
Diese Struktur entspricht weitgehend dem, was ein Incident-Link auf der Statusseite den Lesern ohnehin zeigt: was betroffen ist, seit wann und jedes veröffentlichte Update – lies was eine gute Statusseite während eines Incidents sagt, falls du noch keine Updates für Kunden geschrieben hast.
Warum Incident-Berichte oft nicht geschrieben werden
Der ehrliche Grund, warum die meisten Teams diesen Schritt auslassen, ist nicht Faulheit – es ist das leere Blatt. Wenn ein Incident behoben ist, wollen alle weitermachen, und einen Zeitverlauf aus dem Slack-Verlauf und der Alarm-Historie zu rekonstruieren ist so mühsam, dass es auf unbestimmte Zeit verschoben und dann vergessen wird.
Wie InfraNest den Incident-Bericht für dich entwirft
Das Monitoring von InfraNest hat den Zeitverlauf bereits aufgezeichnet, während der Incident lief – wann er eröffnet wurde, welches Deployment oder welche DNS-Änderung kurz davor live ging, wann er bestätigt wurde, wann sich der Dienst erholt hat. Der Bericht muss nicht aus dem Gedächtnis rekonstruiert werden, weil die Daten in Echtzeit erfasst wurden.
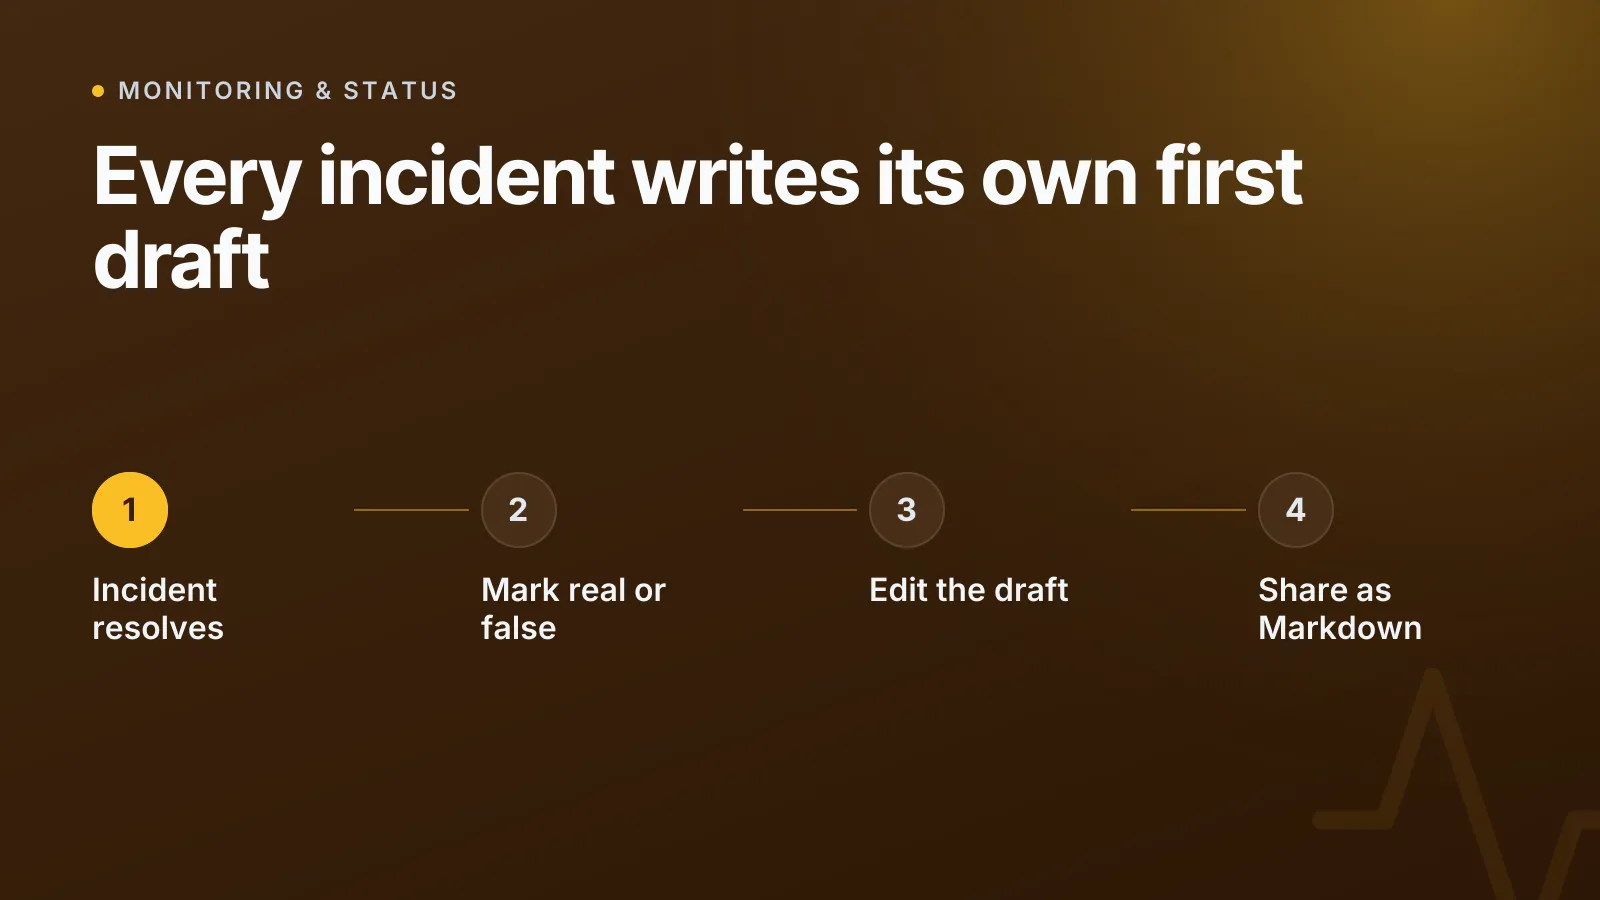
Sobald ein Incident behoben ist, beantwortest du mit einem Klick die Frage „War es ein echtes Problem?“ – echt, Fehlalarm oder erwartet –, optional mit einer Ursache. Diese Antwort zählt über die reine Dokumentation hinaus: Einem Monitor, der immer wieder Fehlalarme auslöst, wird unter Besser überwachen die Einstellung angeboten, die das beheben würde, und der Vorschlag für Monitore, die ständig zwischen up und down wechseln, verdeckt nie einen Ausfall, den du als echt markiert hast.
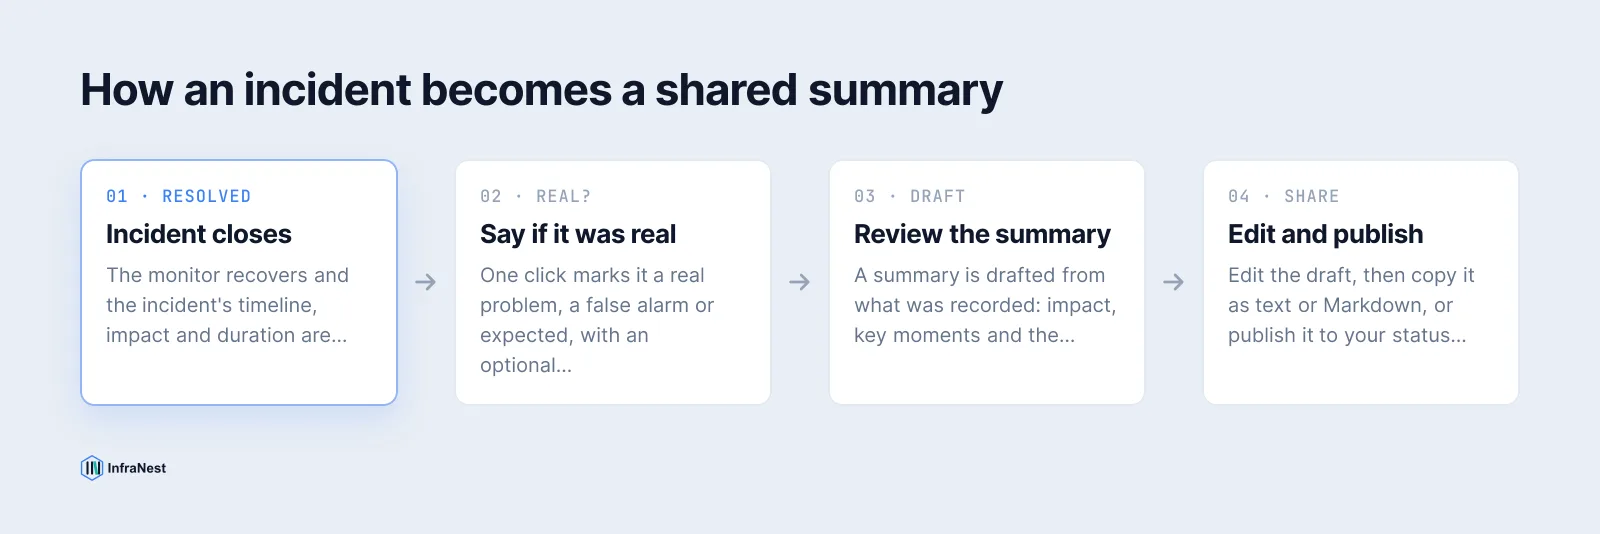
Jeder behobene Incident bekommt außerdem einen aus den aufgezeichneten Daten entworfenen Bericht – was betroffen war und wie lange, die wichtigsten Momente, die wahrscheinliche Ursache und die Änderungen, die direkt vor Beginn vorgenommen wurden. Du bearbeitest ihn, speicherst ihn und kopierst ihn als reinen Text oder Markdown heraus, bereit zum Einfügen in ein Tracker-Ticket, eine Wiki-Seite oder einen Team-Channel. Der vollständige Review-Ablauf geht noch weiter: Trag ein, warum es passiert ist (oder lass auch diesen Teil entwerfen, wenn du das verbunden hast), liste Zeile für Zeile auf, was du ändern wirst, und veröffentliche das Review direkt auf deiner Statusseite, in deinem Doku-Tool, in Confluence, Notion oder Linear – die genauen Schritte findest du in der Incident-Dokumentation. Wenn du die Folgemaßnahmen lieber sofort in nachverfolgte Aufgaben umwandeln willst, kannst du auch nachlesen, wie du Jira- oder Linear-Issues direkt aus Infrastruktur-Ereignissen eröffnest.
Bleib bei einer schuldfreien Sprache
Ein Bericht, in dem steht „Dave hat eine fehlerhafte Config gepusht“, lehrt nichts und hält die nächste Person davon ab, bei einem ähnlichen Fehler ehrlich zu sein. Ein Bericht, in dem steht „In der Deploy-Pipeline gab es keine Prüfung, die diesen Config-Fehler abgefangen hätte“, zeigt auf etwas, das du tatsächlich beheben kannst. Beschreib die Bedingungen, die den Fehler möglich gemacht haben, nicht die Person, die ihn gemacht hat.
WarningHeb dir Berichte nicht nur für die großen Ausfälle auf. Ein zweiminütiger Aussetzer, den niemand bemerkt hat, ist oft die Vorstufe des echten Incidents im nächsten Monat – das Muster wird nur sichtbar, wenn jemand auch die kleinen festgehalten hat.
Einen kurzen, ehrlichen Incident-Bericht zu schreiben, solange die Details noch frisch sind, ist die günstigste Versicherung, die deine Infrastruktur hat. Fang damit an, beim nächsten Ausfall nachzusehen, was dein Monitoring bereits erfasst hat, und lass den ersten Entwurf sich selbst schreiben.
Häufig gestellte Fragen
#Brauche ich für jeden Incident ein vollständiges schriftliches Review?
Nein – heb dir die ausführliche Analyse, warum es passiert ist, für Incidents mit echter Auswirkung auf, und halte bei kleineren nur Auswirkung, Dauer und eine wahrscheinliche Ursache fest, damit die Daten vorhanden sind, falls sich später ein Muster zeigt.
#Wer sollte einen Incident-Bericht eigentlich lesen?
Alle, die wegen etwas Ähnlichem alarmiert werden könnten: die On-Call-Rotation, die für den Dienst verantwortliche Person und deren Teamleitung – nicht nur die Person, die es diesmal zufällig behoben hat.
#Was ist der Unterschied zwischen einem Incident-Bericht und einem Update auf der Statusseite?
Ein Update auf der Statusseite ist kurz, öffentlich und wird für Kunden geschrieben, während der Incident noch läuft. Ein Incident-Bericht ist intern, wird nach der Behebung geschrieben und enthält den Zeitverlauf und die Ursache, die ein Kunden-Update bewusst weglässt.
#Sollte ein Incident-Bericht die Person nennen, die das Problem verursacht hat?
Nein. Schuldfreie Postmortems konzentrieren sich auf die Bedingungen, die den Fehler ermöglicht haben – eine fehlende Prüfung, ein unklares Runbook, keine Canary-Stufe – statt auf die einzelne Person, denn genau das kannst du tatsächlich beheben.
Mit einem kostenlosen Tool ausprobieren
War dieser Artikel hilfreich?