Die meisten Teams alarmieren bei jedem Ausfall, egal wie kurz er ist. Die Lösung: Lege einmal ein Uptime-Ziel fest (etwa 99.9%) und alarmiere nur, wenn das monatliche Ausfallbudget so schnell aufgebraucht wird, dass du das Ziel verfehlen würdest. So bleibt ein zweiminütiger Aussetzer still, während ein langsamer, wiederholter Verbrauch erkannt wird, bevor der Monat vorbei ist.
Das ist die Idee hinter SLA-Burn-Rate-Alerting, einer Praxis, die Googles SRE-Team formalisiert hat und die jetzt direkt in InfraNests Monitoring und Statusseiten eingebaut ist. Hier erfährst du, wie du es richtig einrichtest – egal, welches Tool du nutzt.
Was ist der Unterschied zwischen SLA, SLO und SLI?
Diese drei Begriffe werden oft synonym verwendet, bedeuten aber Unterschiedliches – und es gibt keinen RFC, der auch nur einen davon definiert. Sie stammen aus ITIL und wurden durch Googles SRE Book in Engineering-Teams populär.
- SLI (Service Level Indicator) – die eigentliche Messung, etwa „Prozentsatz erfolgreicher Checks“ oder „Request-Latenz“.
- SLO (Service Level Objective) – dein internes Ziel für diesen SLI, z. B. „99.95% Uptime in diesem Monat“. Es ist meist strenger als das, was du nach außen versprichst, damit du Probleme bemerkst, bevor ein Kunde es tut.
- SLA (Service Level Agreement) – das SLO plus eine Konsequenz: eine Gutschrift, eine Vertragsstrafe, eine vertragliche Verpflichtung. Das ist die Zahl im Vertrag, die deinem Kunden wirklich wichtig ist.
In der Praxis wählen die meisten Teams einfach eine Zahl – sagen wir 99.9% – und verwenden sie für alle drei. Für ein kleines Team ist das völlig in Ordnung. Wichtiger als die Bezeichnung ist, wie du darauf reagierst.
Wie viel Ausfallzeit erlaubt ein SLA-Ziel tatsächlich?
Genau das wird oft unterschätzt. Ein Ziel von 99.9% klingt streng – bis du es in Minuten umrechnest:
| Ziel | Erlaubte Ausfallzeit pro Jahr | Erlaubte Ausfallzeit pro 30-Tage-Monat |
|---|---|---|
| 99% | ~3.65 Tage | ~7.2 Stunden |
| 99.9% | ~8.76 Stunden | ~43.2 Minuten |
| 99.95% | ~4.38 Stunden | ~21.6 Minuten |
| 99.99% | ~52.6 Minuten | ~4.3 Minuten |
| 99.999% | ~5.26 Minuten | ~26 Sekunden |
Sobald du die Zahlen so siehst, werden zwei Dinge klar. Erstens ist 99.9% ein vernünftiger Standard für die meisten Web-Apps – großzügig genug, um ein misslungenes Deployment ohne Panik zu überstehen, und streng genug, um etwas zu bedeuten. Zweitens kratzt ein einzelner zweiminütiger Ausfall kaum am monatlichen Budget von 99.9%, aber drei oder vier davon in einer Woche können das gesamte Monatsbudget schon vor dem 15. aufbrauchen. Was ein beliebiges Ziel in Minuten bedeutet, kannst du mit unserem kostenlosen Uptime-Rechner prüfen.
Warum Alarme bei jedem Ausfall die falsche Voreinstellung sind
SLA-Konsequenzen – Gutschriften, Vertragsstrafen, Mitteilungen über Vertragsverletzungen – werden fast immer über einen ganzen Monat gemessen, nicht pro Vorfall. Genau das ist die Begründung für Burn-Rate-Alerting statt einfacher „Es ist down, sofort alarmieren“-Regeln: Du willst wissen, ob der Monat auf Kurs ist, nicht, ob irgendein einzelner Check fehlgeschlagen ist.
Alarme bei jedem Ausfall führen zu zwei Problemen:
- Alarmmüdigkeit. Eine wackelige Upstream-Abhängigkeit, die sich nach 90 Sekunden erholt, weckt trotzdem jemanden um 3 Uhr nachts. Nach ein paar Wochen ignoriert das Team den Kanal.
- Übersehener schleichender Verbrauch. Ein Dienst, der alle paar Stunden für eine Minute ausfällt, wirkt im Moment nie dringend. Für keinen einzelnen Aussetzer wird jemand alarmiert, aber am 20. des Monats hast du das SLA bereits gerissen – und niemand hat es gemerkt, bis der Monatsbericht des Kunden es zeigte.
Beide Probleme haben dieselbe Ursache: Alarmiert wird auf das Ereignis statt auf den Trend.
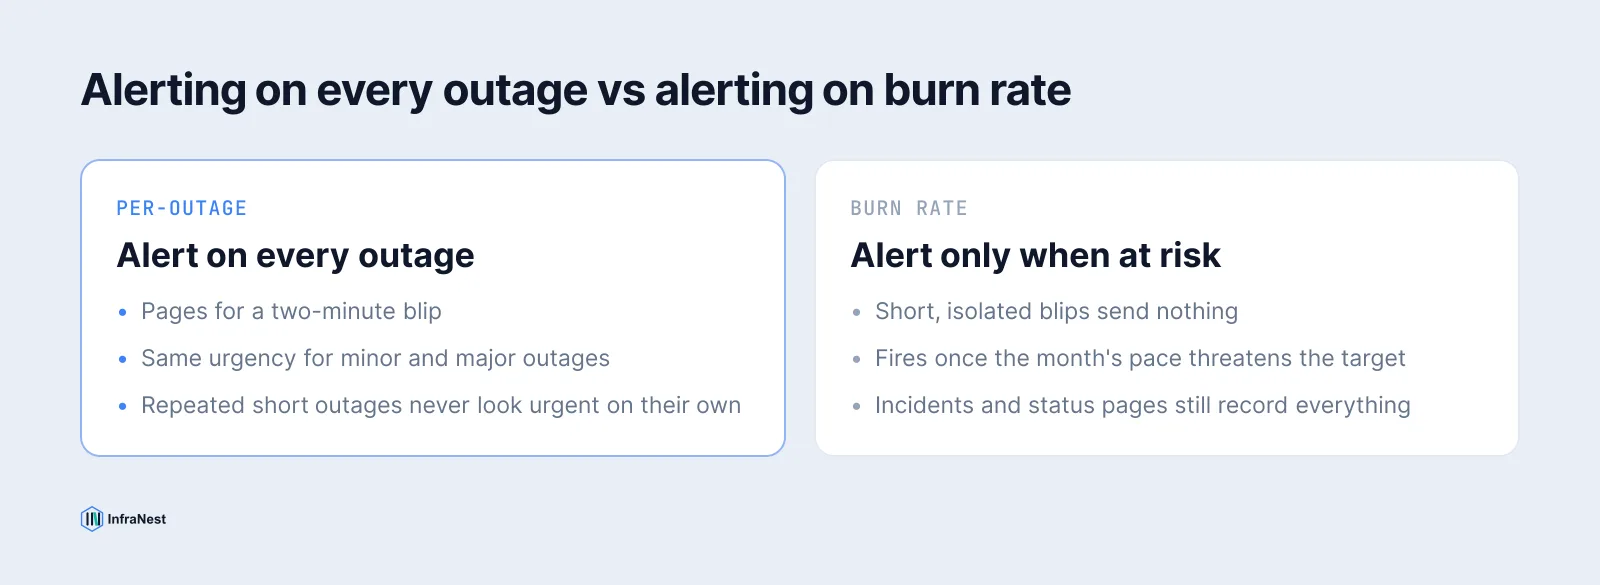
Nach Burn Rate alarmieren statt bei kurzen Aussetzern
Der Ansatz, den Google im SRE Workbook dokumentiert, besteht darin, auf die Burn Rate zu alarmieren – also darauf, wie schnell du dein Fehlerbudget verbrauchst, im Verhältnis zu der Rate, die es genau zum Ende des Zeitraums aufbrauchen würde. Ein kurzer, einzelner Aussetzer bewegt die Burn Rate kaum. Ein Muster wiederholter kurzer Ausfälle oder ein langer Ausfall bewegt sie schnell – und genau das sollte jemanden wecken.
Die praktische Variante, ohne eigene Burn-Rate-Berechnungen:
- Lege den Uptime-Prozentsatz, den du tatsächlich versprichst (schriftlich oder informell), als Ziel für den Monitor oder Dienst fest.
- Verfolge die verbrauchte Ausfallzeit im Verhältnis zum monatlichen Budget im Laufe des Monats, nicht erst am Ende.
- Alarmiere nur, wenn das Verbrauchstempo den Wert zum Monatsende gefährdet – nicht bei jedem einzelnen Fehler.
- Lass Incidents, Statusseiten und Automatisierungen ganz normal weiterlaufen; nur der Alarm pro Ausfall sollte verstummen.
So macht es InfraNest
Mit Uptime-Zielen legst du den Prozentsatz fest, den du versprichst – 99%, 99.9%, 99.95%, 99.99% oder einen beliebigen eigenen Wert von 90% bis 99.999% – für einen Monitor oder eine Statusseite. Die Monitorseite zeigt dann das Ausfallbudget des Kalendermonats als drei Zahlen: Erlaubt, Verbraucht und Übrig, dazu einen Satz, der sagt, wohin der Monat beim aktuellen Tempo steuert, zum Beispiel: „Bei diesem Tempo verfehlt shop.example.com 99.9% um den 18. November.“
Für das Alerting hat jeder Monitor mit Ziel unter So alarmiert dieser Monitor eine Auswahl:
| Modus | Was passiert |
|---|---|
| Bei jedem Ausfall | Ein Alarm jedes Mal, wenn der Monitor ausfällt und wieder erreichbar ist – die alte Voreinstellung |
| Nur wenn das Ziel gefährdet ist | Kein Alarm pro Ausfall; ein Alarm, wenn das Budget so schnell schrumpft, dass das Ziel verfehlt würde, und ein weiterer, wenn es aufgebraucht ist |
Im zweiten Modus löst ein zweiminütiger Aussetzer in einem ansonsten gesunden Monat nichts aus. Eine Website, die alle paar Stunden für eine Minute ausfällt, wird trotzdem erkannt, weil das verbrauchte Budget schneller wächst, als der Monat verkraften kann – und genau dann wird der Alarm ausgelöst. Sobald eine Warnung verschickt wurde, alarmiert jeder Ausfall für den Rest des Monats wieder; am 1. wird die Einstellung still auf „nur wenn gefährdet“ zurückgesetzt. Incidents werden weiterhin eröffnet, deine Statusseite erfasst den Ausfall weiterhin und Automatisierungen laufen weiter – nur der lästige Ping pro Ausfall fällt weg.
Am Monatsende zeigen der Uptime-Bericht, sein CSV-Export und die monatliche E-Mail jedes Ziel als erreicht oder verfehlt an, sodass es keine Unklarheiten gibt, wenn ein Kunde nachfragt. Statusseiten, die ein Ziel veröffentlichen, geben jetzt außerdem an, dass ihr Uptime-Wert nach Auswirkung gewichtet ist, statt einen einminütigen Aussetzer genauso zu behandeln wie einen einstündigen Ausfall.
TipSetze dein internes SLO strenger an als das SLA, das du einem Kunden versprochen hast. Wenn du vertraglich 99.9% zugesagt hast, verfolge intern 99.95% – der Abstand gibt dir Spielraum, Probleme zu erkennen, bevor sie zur Vertragsverletzung werden.
Einrichtung
Für einen Monitor: Öffne ihn, suche die Karte für das Uptime-Ziel, klicke auf Ziel festlegen, wähle einen Prozentsatz und entscheide, wie er alarmiert. Für eine Statusseite: Öffne Einstellungen → Darstellung, wähle unter den Uptime-Schaltern ein Ziel und entscheide dann, ob du es Besuchern anzeigen willst. Das Routing – wer die Warnung erhält und wo – steuerst du genauso wie bei jedem anderen Alarm, über Ziele wie Slack, PagerDuty oder E-Mail.
WarningGeplante Wartungsfenster werden nicht auf das Budget angerechnet, ebenso wenig pausierte Überwachungszeit – gezählt werden nur bestätigte Ausfälle, die einen Incident eröffnet haben. So entspricht der Wert dem, was dein Kunde tatsächlich erlebt hat.
Wenn du noch überlegst, wie oft du überhaupt prüfen solltest: Unser Leitfaden dazu, wie oft du deine Website überwachen solltest, behandelt den Zielkonflikt zwischen Check-Häufigkeit und Fehlalarmen – und der wirkt sich direkt darauf aus, wie sauber deine Burn-Rate-Zahlen am Ende sind.
Lege ein Ziel für deinen wichtigsten Monitor fest, stell sein Alerting auf „nur wenn gefährdet“ um und schau, wie viel ruhiger der nächste Monat wird – starte mit dem Monitoring.
Häufig gestellte Fragen
#Was ist der praktische Unterschied zwischen SLA, SLO und SLI?
Ein SLI ist die reine Messung (etwa der Prozentsatz erfolgreicher Checks), ein SLO ist dein internes Ziel für diese Messung, und ein SLA ist das SLO plus eine vertragliche Konsequenz, etwa eine Gutschrift, falls du es verfehlst. Die meisten kleinen Teams verwenden eine Zahl für alle drei – das ist in Ordnung, solange das Alerting darauf ausgerichtet ist.
#Wie viel Ausfallzeit erlaubt ein SLA von 99.9% tatsächlich pro Monat?
Etwa 43.2 Minuten in einem 30-Tage-Monat und 44.6 Minuten in einem 31-Tage-Monat. Mit dem kostenlosen Uptime-Rechner kannst du das Budget jedes beliebigen Ziels in Minuten prüfen.
#Was passiert, nachdem ein Burn-Rate-Warnalarm ausgelöst wurde?
Für den Rest des Kalendermonats alarmiert jeder Ausfall wieder normal, da die ruhige Phase für gesunde Monate gedacht war. Am 1. des Folgemonats wird das Alerting zurückgesetzt und löst nur noch aus, wenn das neue Budget wieder gefährdet ist.
#Kann ich ein Uptime-Ziel auch für eine Statusseite statt nur für einen einzelnen Monitor festlegen?
Ja. Ein Ziel für eine Statusseite wird als Durchschnitt über die Monitore dieser Seite gemessen – auf derselben Grundlage wie der Uptime-Wert der Seite und ihr Monatsbericht –, statt einen einzelnen Monitor allein an das Versprechen zu binden.
Mit einem kostenlosen Tool ausprobieren
War dieser Artikel hilfreich?