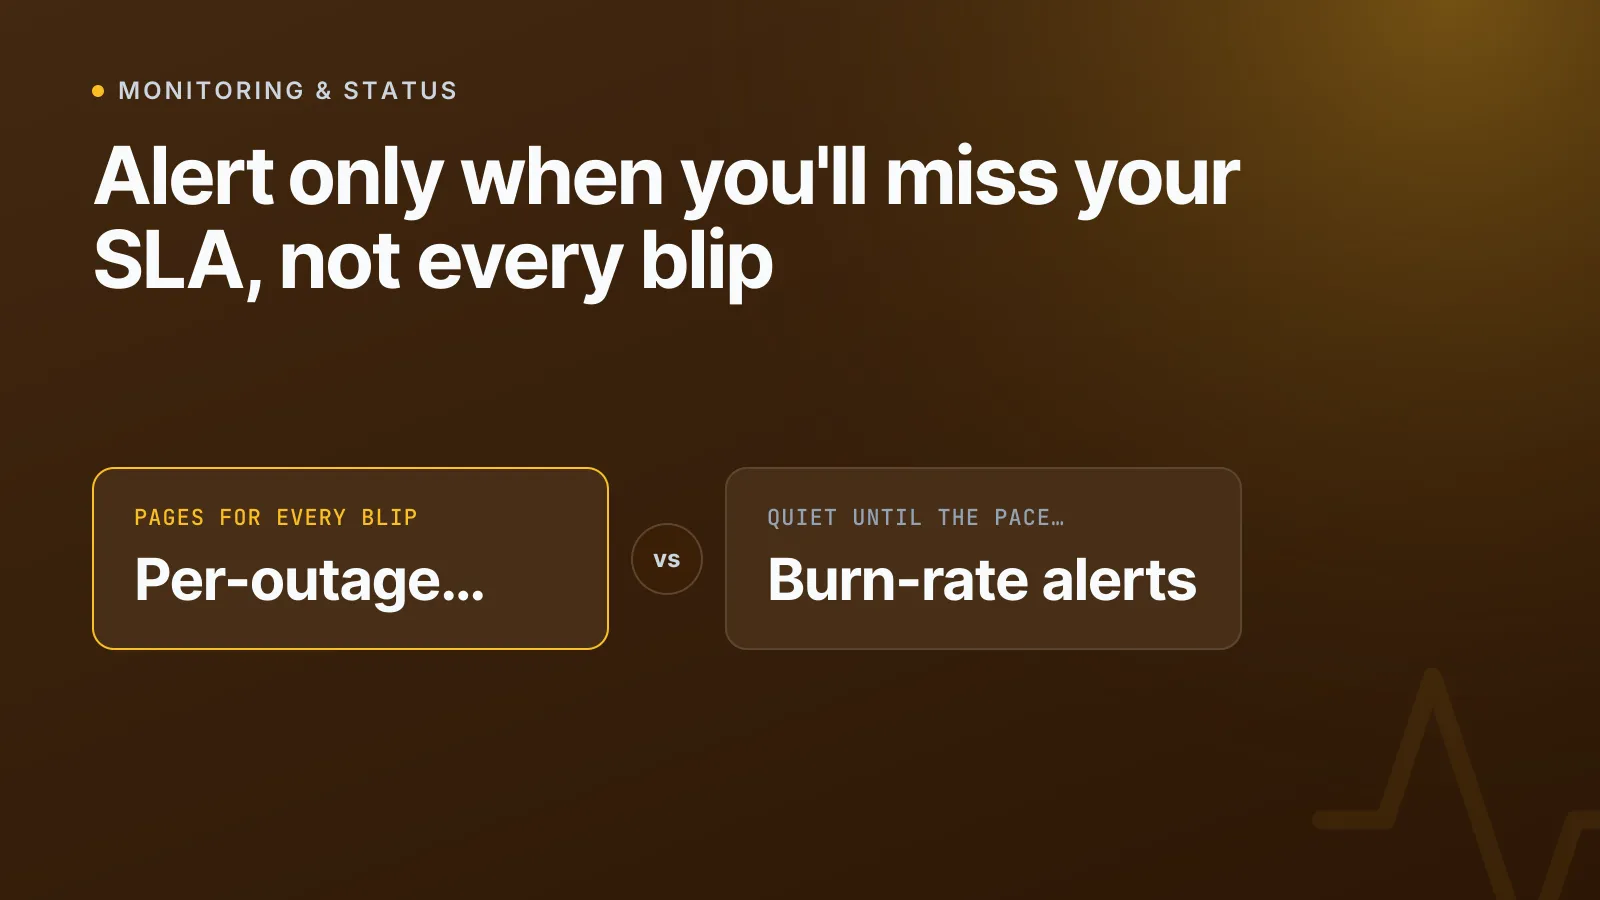
La plupart des équipes déclenchent une alerte à chaque panne, aussi courte soit-elle. La solution consiste à fixer une fois un objectif de disponibilité (par exemple 99.9%) et à n'alerter que lorsque le budget d'indisponibilité du mois se consomme assez vite pour le manquer. Ainsi, une micro-coupure de deux minutes passe sous silence, tandis qu'une érosion lente et répétée est détectée avant la fin du mois.
C'est le principe de l'alerting basé sur le burn rate du SLA, une pratique formalisée par l'équipe SRE de Google et désormais intégrée directement au monitoring et aux pages de statut d'InfraNest. Voici comment la mettre en place correctement, quel que soit votre outil.
Quelle est la différence entre SLA, SLO et SLI ?
Ces trois termes sont souvent employés indifféremment, mais ils ne désignent pas la même chose, et aucune RFC ne les définit. Ils viennent d'ITIL et ont été popularisés auprès des équipes techniques par le SRE Book de Google.
- SLI (Service Level Indicator) : la mesure réelle, comme le « pourcentage de vérifications réussies » ou la « latence des requêtes ».
- SLO (Service Level Objective) : votre objectif interne pour ce SLI, par exemple « 99.95% de disponibilité ce mois-ci ». Il est généralement plus strict que ce que vous promettez à l'extérieur, afin de vous laisser le temps de repérer les problèmes avant un client.
- SLA (Service Level Agreement) : le SLO assorti d'une conséquence : un avoir de service, une clause de pénalité, un engagement contractuel. C'est le chiffre du contrat qui compte réellement pour votre client.
En pratique, la plupart des équipes choisissent un seul chiffre, disons 99.9%, et l'utilisent pour les trois. Pour une petite équipe, c'est très bien. Plus que l'étiquette, ce qui compte, c'est la façon dont vous agissez en conséquence.
Combien d'indisponibilité un objectif SLA autorise-t-il vraiment ?
C'est la partie que l'on sous-estime. Un objectif de 99.9% paraît strict jusqu'à ce qu'on le traduise en minutes :
| Objectif | Indisponibilité autorisée par an | Indisponibilité autorisée par mois de 30 jours |
|---|---|---|
| 99% | ~3.65 jours | ~7.2 heures |
| 99.9% | ~8.76 heures | ~43.2 minutes |
| 99.95% | ~4.38 heures | ~21.6 minutes |
| 99.99% | ~52.6 minutes | ~4.3 minutes |
| 99.999% | ~5.26 minutes | ~26 secondes |
Présentés ainsi, deux constats s'imposent. D'abord, 99.9% est une valeur par défaut raisonnable pour la plupart des applications web : assez généreuse pour encaisser un mauvais déploiement sans panique, assez stricte pour avoir du sens. Ensuite, une seule panne de deux minutes entame à peine un budget mensuel de 99.9%, mais trois ou quatre en une semaine peuvent engloutir toute l'enveloppe du mois avant le 15. Vous pouvez vérifier ce que représente n'importe quel objectif en minutes avec notre calculateur de disponibilité gratuit.
Pourquoi alerter à chaque panne est un mauvais réglage par défaut
Les recours prévus par un SLA (avoirs, pénalités, notifications de manquement) se mesurent presque toujours sur un mois complet, et non sur un incident isolé. C'est toute la justification de l'alerting par burn rate face aux règles simples du type « c'est en panne, alerte immédiate » : vous voulez savoir si le mois est sur la bonne trajectoire, pas si une vérification isolée a échoué.
Alerter à chaque panne entraîne deux dérives :
- La fatigue d'alerte. Une dépendance externe capricieuse qui se rétablit en 90 secondes réveille quand même quelqu'un à 3 h du matin. Au bout de quelques semaines, l'équipe se met à ignorer le canal.
- Les érosions lentes qui passent inaperçues. Un service qui tombe une minute toutes les quelques heures ne semble jamais urgent sur le moment. Personne n'est alerté pour une micro-coupure isolée, mais dès le 20 du mois, le SLA est déjà dépassé sans que personne ne s'en aperçoive, jusqu'à ce que le rapport mensuel du client le révèle.
Ces deux problèmes ont la même cause : on alerte sur l'événement plutôt que sur la tendance.
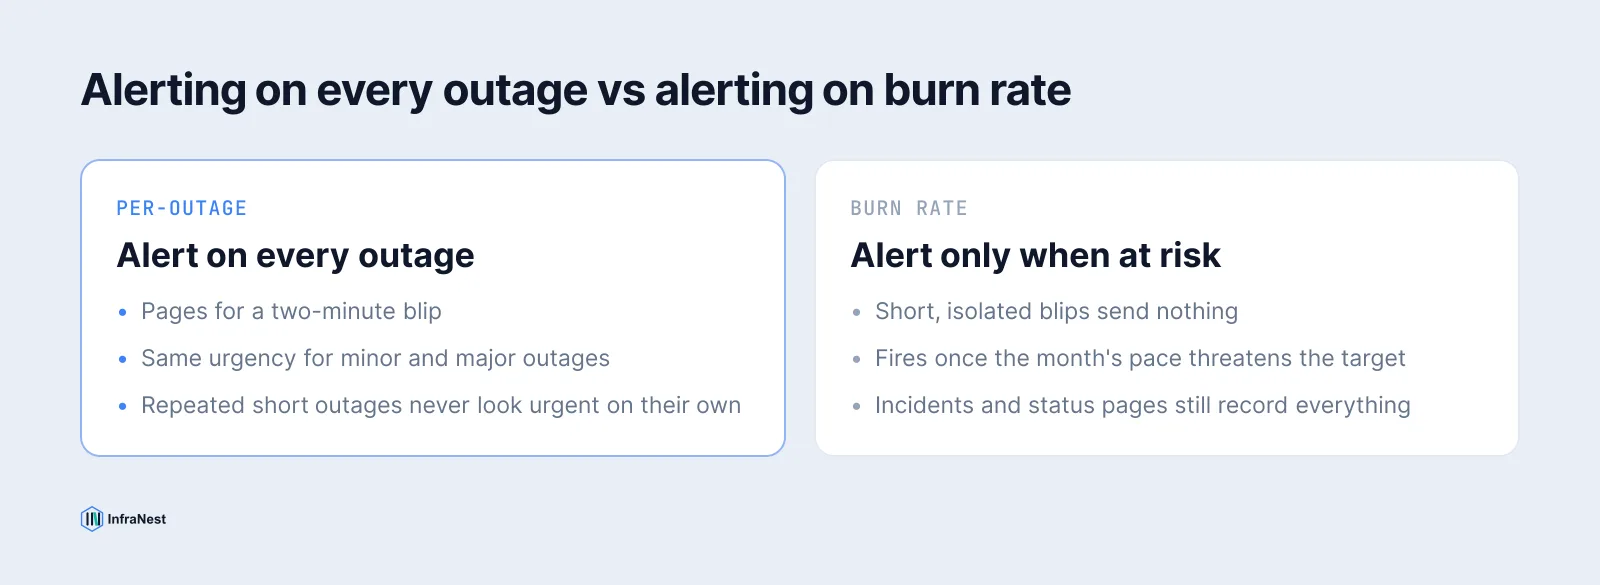
Alerter sur le burn rate, pas sur les micro-coupures
L'approche documentée par Google dans le SRE Workbook consiste à alerter sur le burn rate : la vitesse à laquelle vous consommez votre budget d'erreur, comparée au rythme qui l'épuiserait exactement à la fin de la période. Une micro-coupure brève et isolée fait à peine bouger le burn rate. Une série de courtes pannes répétées, ou une seule panne longue, le fait grimper rapidement, et c'est cela qui doit réveiller quelqu'un.
La version pratique, sans construire vos propres calculs de burn rate :
- Définissez comme objectif, sur le moniteur ou le service, le pourcentage de disponibilité que vous promettez réellement (par écrit ou de manière informelle).
- Suivez l'indisponibilité consommée par rapport au budget mensuel au fil du mois, et pas seulement à la fin.
- N'alertez que lorsque le rythme de consommation menace le résultat de fin de mois, et non à chaque défaillance individuelle.
- Laissez les incidents, les pages de statut et les automatisations fonctionner normalement : seule l'alerte par panne doit se taire.
Comment InfraNest s'y prend
Les objectifs de disponibilité vous permettent de définir le pourcentage que vous promettez (99%, 99.9%, 99.95%, 99.99%, ou toute valeur personnalisée entre 90% et 99.999%) sur un moniteur ou sur une page de statut. La page du moniteur affiche alors le budget d'indisponibilité du mois calendaire sous forme de trois chiffres : Autorisé, Utilisé et Restant, ainsi qu'une phrase indiquant la trajectoire du mois au rythme actuel, par exemple « À ce rythme, shop.example.com manquera 99.9% vers le 18 novembre. »
Pour l'alerting, chaque moniteur doté d'un objectif propose un choix sous Mode d'alerte de ce moniteur :
| Mode | Ce qui se passe |
|---|---|
| À chaque panne | Une alerte à chaque fois que le moniteur tombe puis se rétablit : l'ancien comportement par défaut |
| Uniquement si l'objectif est menacé | Aucune alerte par panne ; une alerte lorsque le budget se consomme assez vite pour manquer l'objectif, puis une autre s'il est épuisé |
Avec le second mode, une micro-coupure de deux minutes au cours d'un mois par ailleurs sain n'envoie rien. Un site qui tombe une minute toutes les quelques heures est malgré tout détecté, car le budget consommé commence à dépasser ce que le mois peut absorber, et c'est précisément à ce moment que l'alerte se déclenche. Une fois l'avertissement envoyé, chaque panne déclenche de nouveau une alerte jusqu'à la fin du mois ; le 1er, le mode revient discrètement à « uniquement si l'objectif est menacé ». Les incidents s'ouvrent toujours, votre page de statut enregistre toujours la panne et les automatisations s'exécutent toujours : seule la notification bruyante à chaque panne disparaît.
En fin de mois, le rapport de disponibilité, son export CSV et l'e-mail mensuel indiquent pour chaque objectif s'il est atteint ou manqué, pour lever toute ambiguïté lorsqu'un client pose la question. Les pages de statut qui publient un objectif précisent désormais aussi que leur taux de disponibilité est pondéré par l'impact, au lieu de traiter une micro-coupure d'une minute comme une panne d'une heure.
TipFixez votre SLO interne plus strictement que le SLA promis au client. Si vous vous êtes engagé contractuellement sur 99.9%, suivez 99.95% en interne : cet écart vous laisse le temps de détecter les problèmes avant qu'ils ne deviennent un manquement.
Mise en place
Sur un moniteur : ouvrez-le, repérez la carte d'objectif de disponibilité, cliquez sur Définir un objectif, choisissez un pourcentage, puis le mode d'alerte. Sur une page de statut : ouvrez Paramètres → Apparence, choisissez un objectif sous les options de disponibilité, puis décidez si vous l'affichez aux visiteurs. Le routage (qui reçoit l'avertissement et où) se configure comme pour toute autre alerte, via des destinations comme Slack, PagerDuty ou l'e-mail.
WarningLes fenêtres de maintenance planifiée ne sont pas décomptées du budget, pas plus que les périodes de monitoring en pause : seules les pannes confirmées ayant ouvert un incident sont comptabilisées, afin que le chiffre corresponde à ce que votre client a réellement vécu.
Si vous hésitez encore sur la fréquence de vos vérifications, notre guide sur la fréquence idéale de surveillance de votre site web détaille le compromis entre fréquence de vérification et faux positifs, qui influence directement la fiabilité de vos chiffres de burn rate.
Définissez un objectif sur votre moniteur le plus important, passez son alerting sur « uniquement si l'objectif est menacé » et constatez à quel point le mois prochain sera plus calme : commencez avec le monitoring.
Questions fréquentes
#Quelle est la différence concrète entre un SLA, un SLO et un SLI ?
Un SLI est la mesure brute (comme le pourcentage de vérifications réussies), un SLO est votre objectif interne pour cette mesure, et un SLA est le SLO assorti d'une conséquence contractuelle, comme un avoir de service, si vous le manquez. La plupart des petites équipes utilisent un seul chiffre pour les trois, ce qui convient tant que l'alerting est configuré autour de ce chiffre.
#Combien d'indisponibilité un SLA de 99.9% autorise-t-il réellement par mois ?
Environ 43.2 minutes sur un mois de 30 jours et 44.6 minutes sur un mois de 31 jours. Vous pouvez vérifier le budget de n'importe quel objectif en minutes avec le calculateur de disponibilité gratuit.
#Que se passe-t-il après le déclenchement d'une alerte de burn rate ?
Chaque panne déclenche normalement une alerte jusqu'à la fin du mois calendaire, car la période silencieuse était prévue pour les mois sans problème. Le 1er du mois suivant, l'alerting revient à ne se déclencher que lorsque le nouveau budget est de nouveau menacé.
#Puis-je définir un objectif de disponibilité sur une page de statut, et pas seulement sur un moniteur ?
Oui. L'objectif d'une page de statut est mesuré comme la moyenne des moniteurs de cette page, sur la même base que le taux de disponibilité de la page et son rapport mensuel, au lieu d'exiger de chaque moniteur qu'il tienne seul la promesse.
Essayez avec un outil gratuit
Cet article vous a-t-il été utile ?