De meeste teams sturen een alert bij elke storing, hoe kort ook. De oplossing: stel één keer een uptimedoel in (zoals 99.9%) en stuur alleen een alert als het downtimebudget van de maand zo snel opraakt dat je dat doel dreigt te missen. Zo blijft een hapering van twee minuten stil, terwijl een langzame, herhaalde leegloop wordt opgemerkt voordat de maand voorbij is.
Dit is het idee achter SLA-burn-rate-alerting, een werkwijze die is geformaliseerd door het SRE-team van Google en die nu rechtstreeks is ingebouwd in de monitoring en statuspagina's van InfraNest. Zo zet je het goed op, welke tool je ook gebruikt.
Wat is het verschil tussen een SLA, SLO en SLI?
Deze drie termen worden vaak door elkaar gebruikt, maar ze betekenen iets anders, en er is geen RFC die ze definieert. Ze komen uit ITIL en zijn onder engineeringteams populair geworden door het SRE Book van Google.
- SLI (Service Level Indicator): de daadwerkelijke meting, zoals "percentage geslaagde checks" of "latency van requests".
- SLO (Service Level Objective): je interne doel voor die SLI, bijvoorbeeld "99.95% uptime deze maand". Dit is meestal strenger dan wat je extern belooft, zodat je ruimte hebt om problemen op te merken voordat een klant dat doet.
- SLA (Service Level Agreement): de SLO plus een consequentie: een servicecredit, een boeteclausule, een contractuele verplichting. Dit is het getal in het contract waar je klant echt om geeft.
In de praktijk kiezen de meeste teams gewoon één getal, bijvoorbeeld 99.9%, en gebruiken dat voor alle drie. Voor een klein team is dat prima. Belangrijker dan het label is wat je ermee doet.
Hoeveel downtime staat een SLA-doel eigenlijk toe?
Dit is het deel dat mensen onderschatten. Een doel van 99.9% klinkt streng, totdat je het omrekent naar minuten:
| Doel | Toegestane downtime per jaar | Toegestane downtime per maand van 30 dagen |
|---|---|---|
| 99% | ~3.65 dagen | ~7.2 uur |
| 99.9% | ~8.76 uur | ~43.2 minuten |
| 99.95% | ~4.38 uur | ~21.6 minuten |
| 99.99% | ~52.6 minuten | ~4.3 minuten |
| 99.999% | ~5.26 minuten | ~26 seconden |
Als je de getallen zo bekijkt, worden twee dingen duidelijk. Ten eerste is 99.9% een redelijke standaard voor de meeste webapps: ruim genoeg om een mislukte deploy zonder paniek te overleven, streng genoeg om iets te betekenen. Ten tweede maakt één storing van twee minuten nauwelijks een deuk in een maandbudget van 99.9%, maar drie of vier daarvan in één week kunnen het hele maandbudget al vóór de 15e opsouperen. Met onze gratis uptimecalculator zie je voor elk doel wat het in minuten betekent.
Waarom een alert bij elke storing de verkeerde standaard is
SLA-compensaties (credits, boetes, meldingen van contractbreuk) worden bijna altijd over een volledige maand gemeten, niet per incident. Dat is precies waarom burn-rate-alerting beter werkt dan simpele regels als "hij ligt eruit, stuur nu een alert": je wilt weten of de maand op koers ligt, niet of een individuele check is mislukt.
Een alert bij elke storing leidt tot twee problemen:
- Alertmoeheid. Een wankele upstream-dependency die binnen 90 seconden herstelt, piept om 3 uur 's nachts nog steeds iemand op. Na een paar weken begint het team het kanaal te negeren.
- Gemiste langzame leegloop. Een dienst die om de paar uur een minuut plat ligt, lijkt op het moment zelf nooit urgent. Niemand wordt opgepiept voor één enkele hapering, maar op de 20e van de maand heb je de SLA al overschreden, en niemand had het door totdat het maandrapport van de klant het liet zien.
Beide problemen hebben dezelfde oorzaak: je alarmeert op de gebeurtenis in plaats van op de trend.
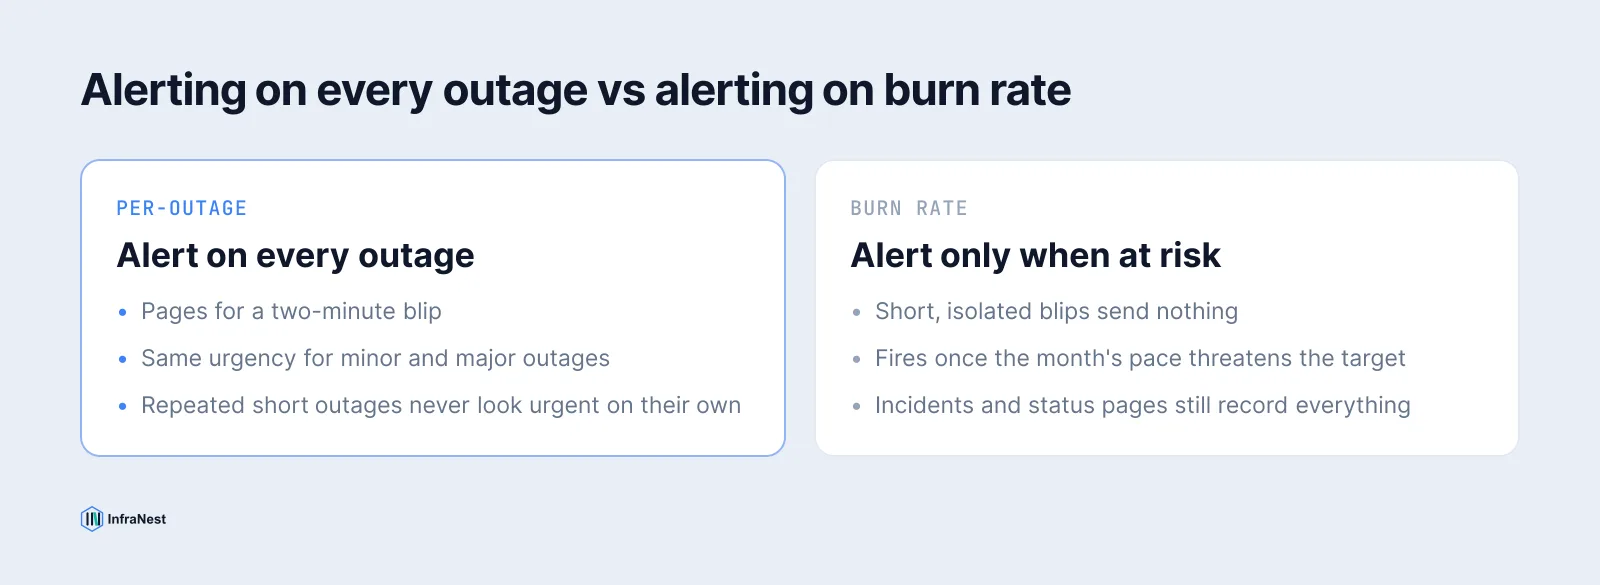
Alert op burn rate, niet op korte haperingen
De aanpak die Google beschrijft in het SRE Workbook is alerten op burn rate: hoe snel je je error budget verbruikt ten opzichte van het tempo waarmee het precies aan het einde van de periode op zou zijn. Een korte, losse hapering verandert de burn rate nauwelijks. Een patroon van herhaalde korte storingen, of één lange, laat hem snel stijgen, en dát is waarvoor iemand wakker gemaakt moet worden.
De praktische versie, zonder zelf burn-rate-berekeningen te bouwen:
- Stel het uptimepercentage dat je daadwerkelijk belooft (schriftelijk of informeel) in als doel op de monitor of dienst.
- Houd de verbruikte downtime ten opzichte van het maandbudget bij terwijl de maand vordert, niet alleen aan het einde.
- Stuur alleen een alert als het verbruikstempo het eindcijfer van de maand bedreigt, niet bij elke individuele storing.
- Laat incidenten, statuspagina's en automatiseringen gewoon doorlopen; alleen de alert per storing hoeft stil te worden.
Zo doet InfraNest het
Met uptimedoelen stel je het percentage in dat je belooft (99%, 99.9%, 99.95%, 99.99% of een eigen waarde tussen 90% en 99.999%) op een monitor of op een statuspagina. De monitorpagina toont dan het downtimebudget van de kalendermaand in drie getallen: Toegestaan, Gebruikt en Over, plus één zin die aangeeft waar de maand in het huidige tempo naartoe gaat, bijvoorbeeld "In dit tempo mist shop.example.com rond 18 november de 99.9%."
Voor alerting heeft elke monitor met een doel een keuze onder Hoe deze monitor alerts stuurt:
| Modus | Wat er gebeurt |
|---|---|
| Bij elke storing | Een alert telkens wanneer de monitor uitvalt en weer terugkomt (de oude standaard) |
| Alleen als het doel in gevaar is | Geen alert per storing; één alert als het budget zo snel opraakt dat het doel gemist dreigt te worden, en nog één als het op is |
In de tweede modus stuurt een hapering van twee minuten in een verder gezonde maand helemaal niets. Een site die om de paar uur een minuut wegvalt, wordt toch opgemerkt, omdat het verbruikte budget sneller oploopt dan de maand kan opvangen, en precies dan gaat de alert af. Zodra er een waarschuwing is verstuurd, stuurt elke storing de rest van die maand weer een alert; op de 1e wordt dit stilletjes teruggezet naar "alleen als het doel in gevaar is". Incidenten worden nog steeds geopend, je statuspagina registreert de storing nog steeds en automatiseringen draaien gewoon door. Alleen de luidruchtige melding per storing verdwijnt.
Aan het einde van de maand tonen het uptimerapport, de CSV-export ervan en de maandelijkse e-mail elk doel als gehaald of gemist, zodat er geen onduidelijkheid is als een klant ernaar vraagt. Statuspagina's die een doel publiceren, vermelden nu ook dat hun uptimecijfer naar impact is gewogen, in plaats van een hapering van één minuut gelijk te behandelen aan een storing van een uur.
TipStel je interne SLO strenger in dan de SLA die je een klant hebt beloofd. Heb je in een contract 99.9% toegezegd, houd dan intern 99.95% aan. Dat verschil geeft je ruimte om problemen op te vangen voordat ze tot contractbreuk leiden.
Instellen
Op een monitor: open hem, zoek de kaart voor het uptimedoel, klik op Doel instellen, kies een percentage en bepaal hoe hij alerts stuurt. Op een statuspagina: open Instellingen → Weergave, kies een doel onder de uptimeschakelaars en bepaal of je het aan bezoekers wilt tonen. De routering (wie de waarschuwing krijgt en waar) regel je op dezelfde manier als bij elke andere alert, via bestemmingen zoals Slack, PagerDuty of e-mail.
WarningGepland onderhoud telt niet mee voor het budget, en gepauzeerde monitoringtijd ook niet. Alleen bevestigde storingen waarvoor een incident is geopend, worden meegeteld, zodat het cijfer overeenkomt met wat je klant daadwerkelijk heeft ervaren.
Twijfel je nog hoe vaak je überhaupt moet controleren? Onze gids over hoe vaak je je website moet monitoren behandelt de afweging tussen checkfrequentie en false positives, en die bepaalt direct hoe zuiver je burn-rate-cijfers uiteindelijk zijn.
Stel een doel in op je belangrijkste monitor, zet de alerting op "alleen als het doel in gevaar is" en merk hoeveel rustiger volgende maand is. Begin met monitoring.
Veelgestelde vragen
#Wat is in de praktijk het verschil tussen een SLA, een SLO en een SLI?
Een SLI is de ruwe meting (zoals het percentage geslaagde checks), een SLO is je interne doel voor die meting, en een SLA is de SLO plus een contractuele consequentie, zoals een servicecredit, als je het doel mist. De meeste kleine teams gebruiken één getal voor alle drie. Dat is prima, zolang de alerting daaromheen is ingericht.
#Hoeveel downtime staat een SLA van 99.9% per maand eigenlijk toe?
Ongeveer 43.2 minuten in een maand van 30 dagen en 44.6 minuten in een maand van 31 dagen. Met de gratis uptimecalculator zie je voor elk doel hoeveel minuten downtime het toestaat.
#Wat gebeurt er nadat een burn-rate-waarschuwing is verstuurd?
Elke storing stuurt de rest van die kalendermaand weer gewoon een alert, omdat de stille periode bedoeld was voor gezonde maanden. Op de 1e van de volgende maand wordt de alerting teruggezet, zodat er pas weer een alert komt als het nieuwe budget in gevaar komt.
#Kan ik een uptimedoel instellen op een statuspagina en niet alleen op een losse monitor?
Ja. Het doel van een statuspagina wordt gemeten als het gemiddelde over de monitors op die pagina, op dezelfde basis als het eigen uptimecijfer van de pagina en het maandrapport. Er wordt dus geen enkele monitor afzonderlijk aan de belofte gehouden.
Probeer het met een gratis tool
Was dit artikel nuttig?