Een goede incidentsamenvatting beantwoordt vijf vragen: wat ging er mis, hoe lang duurde het, wat gebeurde er wanneer, waarom gebeurde het en wat verander je zodat het niet opnieuw gebeurt. Schrijf hem op de dag dat je het incident afsluit, niet drie weken later. Tegen die tijd weet niemand meer welke deploy als eerste live ging, en een samenvatting die niemand leest zolang alles nog vers is, leert je team niets.
Een incidentsamenvatting is iets anders dan de update voor klanten op je statuspagina. Het is een intern verslag, meestal geschreven zodra het incident is opgelost, bedoeld voor de volgende engineer die wordt opgepiept voor iets dat er sterk op lijkt. Zet je de structuur goed neer, dan wordt het een naslagwerk. Doe je het verkeerd (vaag, gericht op schuld of helemaal niet geschreven), dan gebeurt dezelfde storing over zes maanden opnieuw en weet niemand meer dat het de eerste keer ook al gebeurde.
Wat is een incidentsamenvatting en waarom zou je er een schrijven?
"Lessons learned" is letterlijk een benoemde fase in de richtlijnen voor incidentafhandeling van NIST (SP 800-61): je lost het probleem niet alleen op, je legt ook vast wat je anders zou doen. Het SRE-boek van Google heeft een heel hoofdstuk over postmortemcultuur dat om hetzelfde idee draait: de samenvatting is het mechanisme waarmee een storing uitmondt in een verbetering in plaats van alleen een slechte middag.
De gewoonte die dit laat werken, is blameless schrijven, een term die teruggaat op het werk van John Allspaw bij Etsy. De samenvatting beschrijft wat het systeem deed en waarom die handelwijze onder de omstandigheden logisch was, niet wie de schuld krijgt. Mensen houden informatie achter als ze verwachten dat ze erop worden afgerekend, en dat is precies de informatie die een bruikbare incidentsamenvatting nodig heeft.
Wat hoort er in een goede incidentsamenvatting?
Een bruikbare incidentsamenvatting behandelt minimaal:
| Onderdeel | Welke vraag het beantwoordt |
|---|---|
| Impact | Wat werd geraakt en wie merkte het op |
| Duur | Wanneer het begon, wanneer het werd gedetecteerd, wanneer het werd opgelost |
| Tijdlijn | De belangrijkste momenten op volgorde: deploy, alert, bevestiging, fix |
| Waarschijnlijke oorzaak | De meest aannemelijke verklaring, met onderbouwing |
| Bijdragende wijzigingen | Wat er kort ervoor veranderde: een deploy, een DNS-aanpassing, een configuratiewijziging |
| Wat we veranderen | De concrete vervolgacties, elk met een eigenaar |
Ernstlabels zoals SEV1–SEV4 zijn handig als korte aanduiding van hoe dringend iets een samenvatting nodig heeft, maar er is geen RFC of branchestandaard die ze definieert. De SEV2 van elk team betekent net iets anders, dus ga er niet van uit dat een label alleen de impact duidelijk maakt aan iemand buiten je team.
TipSchrijf het onderdeel "wat is er veranderd" voordat je de oorzaak beschrijft. Bij de meeste storingen is de oorzaak een recente wijziging: een deploy, een certificaatvernieuwing die stilletjes mislukte, een firewallregel, een verlopen DNS-record. Door daar eerst te kijken, hoef je niet te gissen.
Teamnotities vs. updates voor klanten: haal ze niet door elkaar
Een incidentsamenvatting en een update op je statuspagina hebben verschillende lezers en mogen nooit hetzelfde document zijn. Een teamnotitie kan zeggen "database wordt herstart, over 5 min terug" en intern blijven. Een update op je statuspagina moet korter en eenvoudiger zijn, zonder interne details die je klanten niet nodig hebben: wat er geraakt is, ongeveer wanneer het opgelost is, meer niet.
Houd je die twee gescheiden, dan voorkom je de bekende valkuil: óf de publieke update leest als een intern debuglog, óf de interne samenvatting is zo opgeschoond voor klanten dat je eigen team er niets van kan leren.
Een template voor een incidentsamenvatting om te kopiëren
Gebruik dit als basisstructuur en schrap alles wat niet van toepassing is:
## Incident: Checkout API returning 500s

**Impact:** Checkout failed for ~18% of requests
**Duration:** 14:02–14:31 UTC (29 minutes)
**Detected by:** Automated monitoring, 2 minutes after start

### Timeline
- 13:58 — Deploy of api-gateway v2.14 to production
- 14:02 — Error rate alert fires
- 14:04 — On-call acknowledges
- 14:09 — Deploy identified as likely cause
- 14:14 — Rollback started
- 14:31 — Error rate back to baseline

### Likely cause
The v2.14 deploy changed a connection pool default, exhausting
database connections under peak load.

### What we change
- [ ] Add a connection-pool size alert before it's exhausted
- [ ] Add a canary stage before full rollout for api-gateway
- [ ] Document the rollback command in the runbook
Die structuur sluit nauw aan bij wat een incidentlink op een statuspagina een lezer al laat zien: wat er geraakt is, sinds wanneer en elke geplaatste update. Lees wat een goede statuspagina zegt tijdens een incident als je nog nooit updates voor klanten hebt geschreven.
Waarom incidentsamenvattingen vaak niet worden geschreven
De eerlijke reden dat de meeste teams deze stap overslaan, is geen luiheid, maar het lege vel. Tegen de tijd dat een incident is opgelost, wil iedereen door, en een tijdlijn reconstrueren uit Slack-geschiedenis en alerthistorie is zo omslachtig dat het eindeloos wordt uitgesteld en daarna vergeten.
Hoe InfraNest de incidentsamenvatting voor je opstelt
De monitoring van InfraNest heeft de tijdlijn al vastgelegd terwijl het incident plaatsvond: wanneer het werd geopend, welke deploy of DNS-wijziging er net daarvoor doorkwam, wanneer het werd bevestigd, wanneer het herstelde. De samenvatting hoeft niet uit het geheugen te worden gereconstrueerd, omdat de gegevens werden vastgelegd op het moment zelf.
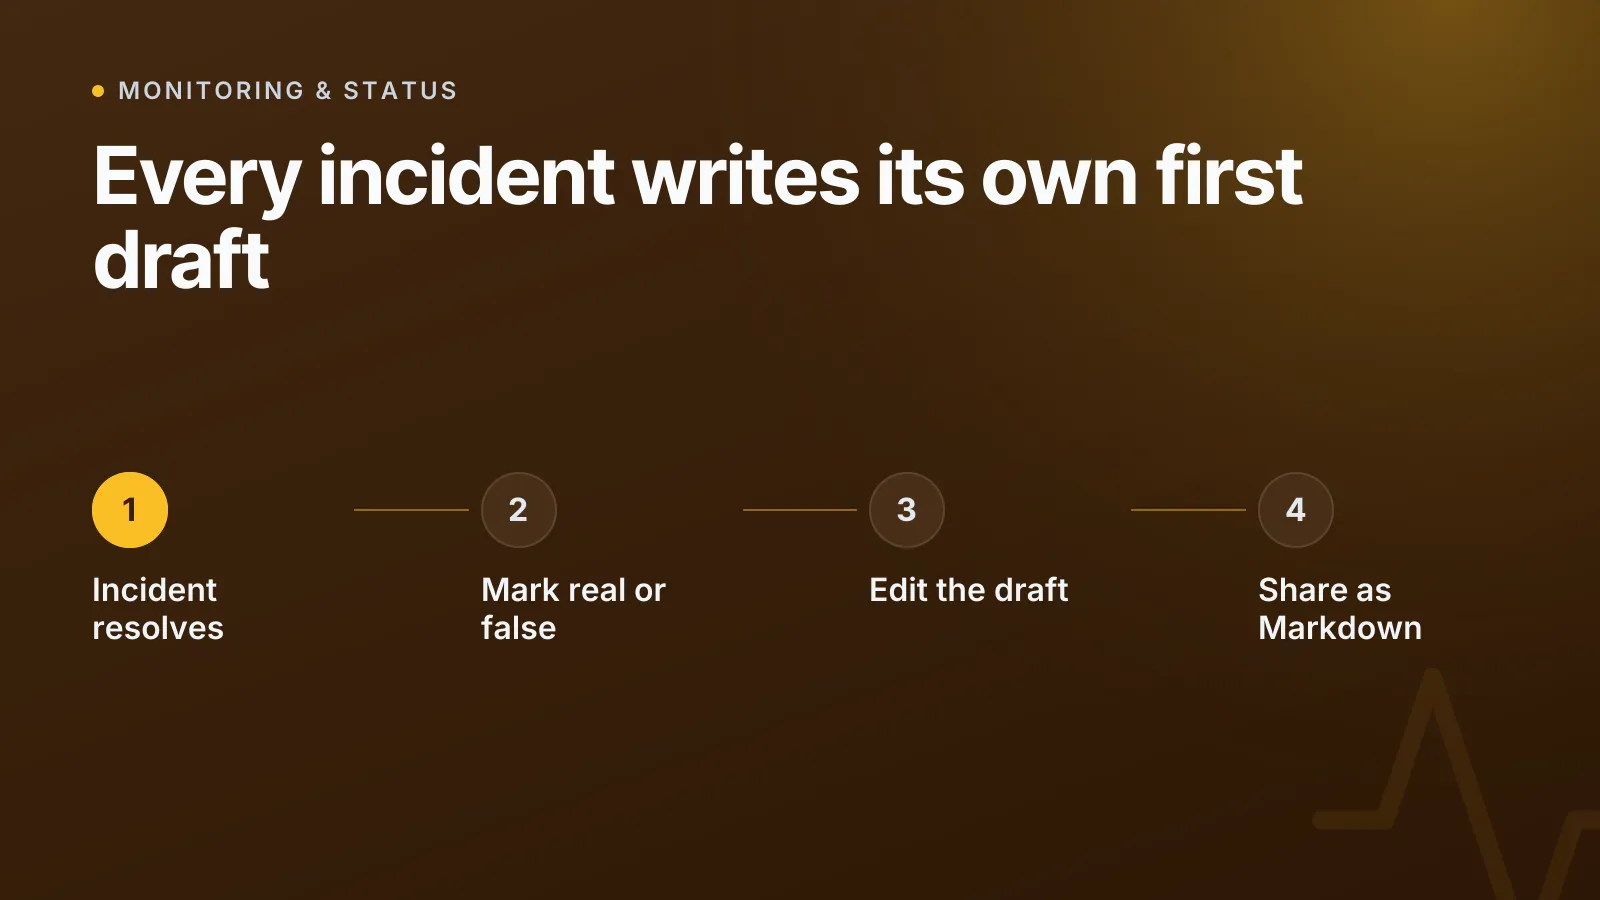
Zodra een incident is opgelost, beantwoord je met één klik de vraag "Was het een echt probleem?": echt, vals alarm of verwacht, met een optionele oorzaak. Dat antwoord is meer dan administratie: een monitor die steeds vals alarm geeft, krijgt onder Beter bewaken de instelling aangeboden die het zou oplossen, en de suggestie voor monitors die steeds op en neer schieten verbergt nooit een storing die je als echt hebt gemarkeerd.
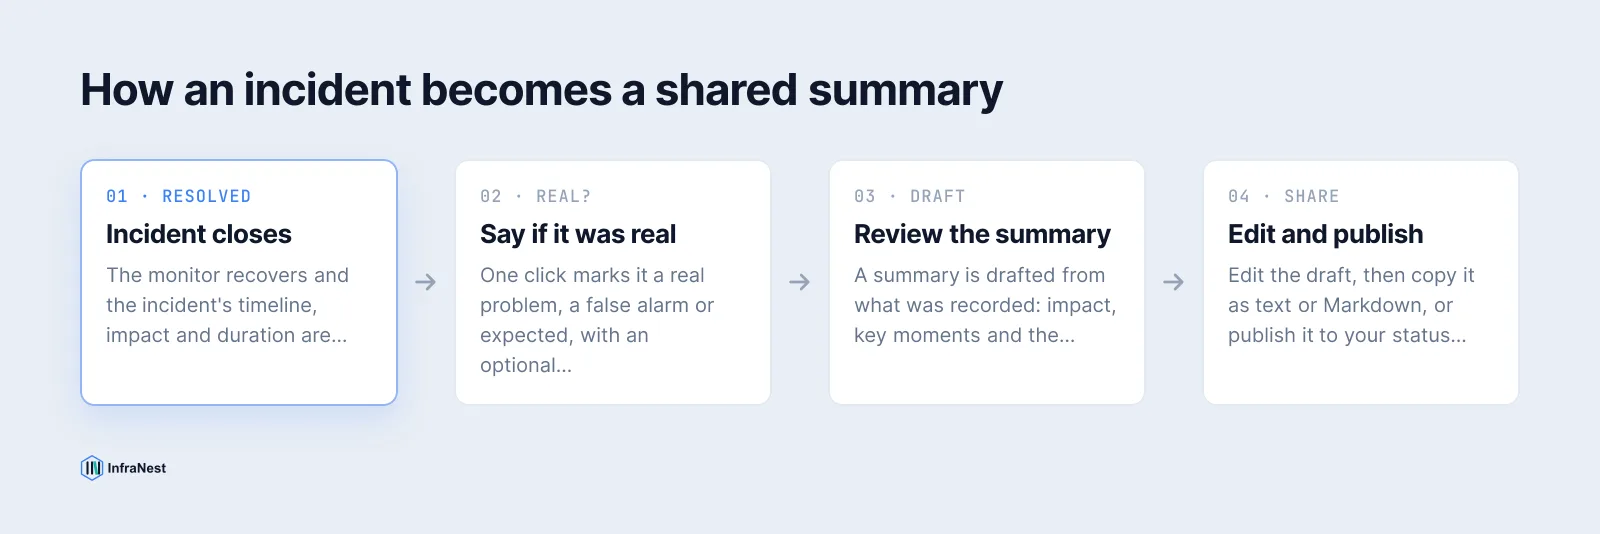
Elk opgelost incident krijgt ook een samenvatting opgesteld op basis van wat er is vastgelegd: wat er geraakt was en hoe lang, de belangrijkste momenten, de waarschijnlijke oorzaak en de wijzigingen die vlak voor het begin werden doorgevoerd. Je bewerkt hem, slaat hem op en kopieert hem als platte tekst of Markdown, klaar om te plakken in een ticket in je tracker, een wikipagina of een teamkanaal. De volledige reviewflow gaat nog verder: vul in waarom het gebeurde (of laat ook dat deel opstellen, als je dat hebt gekoppeld), noteer regel voor regel wat je gaat veranderen en publiceer de review direct naar je statuspagina, documentatietool, Confluence, Notion of Linear. Zie de documentatie over incidenten voor de precieze stappen. Wil je de vervolgacties meteen omzetten in werk dat je kunt volgen, lees dan ook over Jira- of Linear-issues direct aanmaken vanuit infrastructuurgebeurtenissen.
Houd de taal blameless
Een samenvatting met "Dave heeft een foute config gepusht" leert niemand iets en ontmoedigt de volgende om eerlijk te zijn over een vergelijkbare fout. Een samenvatting met "de deploypipeline had geen controle die deze configuratiefout had kunnen onderscheppen" wijst naar iets wat je echt kunt oplossen. Beschrijf de omstandigheden die de fout mogelijk maakten, niet de persoon die hem maakte.
WarningBewaar samenvattingen niet alleen voor de grote storingen. Een hapering van twee minuten die niemand opmerkte, is vaak de voorloper van het echte incident van volgende maand. Het patroon wordt pas zichtbaar als iemand ook de kleine incidenten heeft vastgelegd.
Een korte, eerlijke incidentsamenvatting schrijven terwijl de details nog vers zijn, is de goedkoopste verzekering die je infrastructuur heeft. Begin de volgende keer dat er iets misgaat met bekijken wat je monitoring al heeft vastgelegd, en laat de eerste versie zichzelf schrijven.
Veelgestelde vragen
#Heb ik voor elk incident een volledige schriftelijke review nodig?
Nee. Bewaar de uitgebreide uitleg over waarom het gebeurde voor incidenten met echte impact, en leg bij kleine incidenten alleen de impact, de duur en een waarschijnlijke oorzaak vast, zodat de gegevens er zijn als er later een patroon opduikt.
#Wie zou een incidentsamenvatting eigenlijk moeten lezen?
Iedereen die opgepiept kan worden voor iets vergelijkbaars: de on-callrotatie, de eigenaar van de service en hun teamleider, niet alleen degene die het deze keer toevallig oploste.
#Wat is het verschil tussen een incidentsamenvatting en een update op de statuspagina?
Een update op de statuspagina is kort, openbaar en geschreven voor klanten terwijl het incident nog loopt. Een incidentsamenvatting is intern, wordt na de oplossing geschreven en bevat de tijdlijn en oorzaak die een update voor klanten bewust weglaat.
#Moet een incidentsamenvatting de persoon noemen die het probleem veroorzaakte?
Nee. Een blameless postmortem richt zich op de omstandigheden die de fout mogelijk maakten, zoals een ontbrekende controle, een onduidelijk runbook of geen canary-fase, in plaats van op de persoon, omdat je dat echt kunt oplossen.
Probeer het met een gratis tool
Was dit artikel nuttig?