Un bon rapport d'incident répond à cinq questions : qu'est-ce qui est tombé en panne, combien de temps cela a duré, ce qui s'est passé et à quel moment, pourquoi c'est arrivé, et ce qui va changer pour éviter que cela se reproduise. Rédigez-le le jour même de la clôture de l'incident, pas trois semaines plus tard : à ce stade, plus personne ne se souvient du déploiement parti en premier, et un rapport que personne ne lit tant que les faits sont frais n'apprend rien à votre équipe.
Un rapport d'incident n'est pas la même chose que la mise à jour destinée aux clients sur votre page de statut. C'est un document interne, généralement rédigé une fois l'incident résolu, à l'intention du prochain ingénieur qui sera alerté pour un problème qui y ressemble. Avec la bonne structure, il devient une référence. Avec la mauvaise (flou, orienté vers la recherche d'un coupable, ou jamais rédigé), la même panne se reproduit six mois plus tard sans que personne se souvienne qu'elle a déjà eu lieu.
Qu'est-ce qu'un rapport d'incident (post-mortem), et pourquoi en rédiger un ?
Le « retour d'expérience » (lessons learned) est littéralement une phase à part entière des recommandations du NIST sur la gestion des incidents (SP 800-61) : il ne suffit pas de corriger le problème, il faut consigner ce que l'on ferait différemment. Le livre SRE de Google consacre un chapitre entier à la culture du post-mortem, bâtie sur la même idée : le rapport est le mécanisme qui transforme une panne en amélioration, au lieu d'en faire simplement un mauvais après-midi.
L'habitude qui fait fonctionner tout cela, c'est la rédaction sans recherche de coupable (blameless), une notion qui remonte aux travaux de John Allspaw chez Etsy. Le rapport décrit ce qu'a fait le système et pourquoi les circonstances rendaient ce comportement compréhensible, pas qui blâmer. Les gens dissimulent des informations quand ils s'attendent à en être tenus pour responsables, et ce sont précisément ces informations dont un rapport d'incident utile a besoin.
Que doit contenir un bon rapport d'incident ?
Au minimum, un rapport d'incident exploitable couvre :
| Section | Ce à quoi elle répond |
|---|---|
| Impact | Ce qui a été touché, et qui s'en est aperçu |
| Durée | Quand l'incident a commencé, quand il a été détecté, quand il a été résolu |
| Chronologie | Les moments clés dans l'ordre : déploiement, alerte, prise en charge, correctif |
| Cause probable | L'explication la plus vraisemblable, avec des éléments à l'appui |
| Changements contributifs | Ce qui a changé peu avant : un déploiement, une modification DNS, une mise à jour de configuration |
| Ce que nous changeons | Les actions de suivi concrètes, chacune avec un responsable |
Les niveaux de gravité comme SEV1–SEV4 sont un raccourci pratique pour indiquer l'urgence d'un rapport, mais aucune RFC ni aucune norme du secteur ne les définit : le SEV2 de chaque équipe signifie quelque chose de légèrement différent. Ne partez donc pas du principe qu'une étiquette suffit à communiquer l'impact à quelqu'un d'extérieur à votre équipe.
TipRédigez la section « ce qui a changé » avant la cause. Dans la plupart des pannes, la cause est un changement récent : un déploiement, un renouvellement de certificat qui a échoué sans bruit, une règle de pare-feu, un enregistrement DNS expiré. Commencer par là vous évite de deviner.
Notes d'équipe et communication client : ne les confondez pas
Un rapport d'incident et une mise à jour de page de statut s'adressent à des lecteurs différents et ne doivent jamais être le même document. Une note d'équipe peut dire « redémarrage de la base de données, retour dans 5 min » et rester interne. Une mise à jour de page de statut doit être plus courte, plus simple et débarrassée des détails internes dont vos clients n'ont pas besoin : ce qui est touché, à peu près quand ce sera corrigé, rien de plus.
En séparant les deux, vous évitez l'écueil classique : soit la mise à jour publique ressemble à un journal de débogage interne, soit le rapport interne est tellement aseptisé pour les clients que votre propre équipe ne peut rien en apprendre.
Un modèle de rapport d'incident à copier-coller
Utilisez-le comme structure de départ et supprimez tout ce qui ne s'applique pas :
## Incident: Checkout API returning 500s

**Impact:** Checkout failed for ~18% of requests
**Duration:** 14:02–14:31 UTC (29 minutes)
**Detected by:** Automated monitoring, 2 minutes after start

### Timeline
- 13:58 — Deploy of api-gateway v2.14 to production
- 14:02 — Error rate alert fires
- 14:04 — On-call acknowledges
- 14:09 — Deploy identified as likely cause
- 14:14 — Rollback started
- 14:31 — Error rate back to baseline

### Likely cause
The v2.14 deploy changed a connection pool default, exhausting
database connections under peak load.

### What we change
- [ ] Add a connection-pool size alert before it's exhausted
- [ ] Add a canary stage before full rollout for api-gateway
- [ ] Document the rollback command in the runbook
Cette structure correspond de près à ce que le lien d'un incident sur une page de statut montre déjà au lecteur : ce qui est touché, depuis quand, et chaque mise à jour publiée. Consultez ce que doit dire une bonne page de statut pendant un incident si vous n'avez encore jamais rédigé de communication destinée aux clients.
Pourquoi les rapports d'incident ne sont souvent pas rédigés
La vraie raison pour laquelle la plupart des équipes sautent cette étape n'est pas la paresse, c'est la page blanche. Une fois l'incident résolu, tout le monde veut passer à autre chose, et reconstituer une chronologie à partir de l'historique Slack et des alertes est suffisamment fastidieux pour être repoussé indéfiniment, puis oublié.
Comment InfraNest rédige le rapport d'incident à votre place
Le monitoring d'InfraNest a déjà enregistré la chronologie pendant l'incident : quand il s'est ouvert, quel déploiement ou changement DNS est intervenu juste avant, quand il a été pris en charge, quand le service est revenu. Le rapport n'a pas besoin d'être reconstitué de mémoire, puisque les données ont été capturées au fil de l'eau.
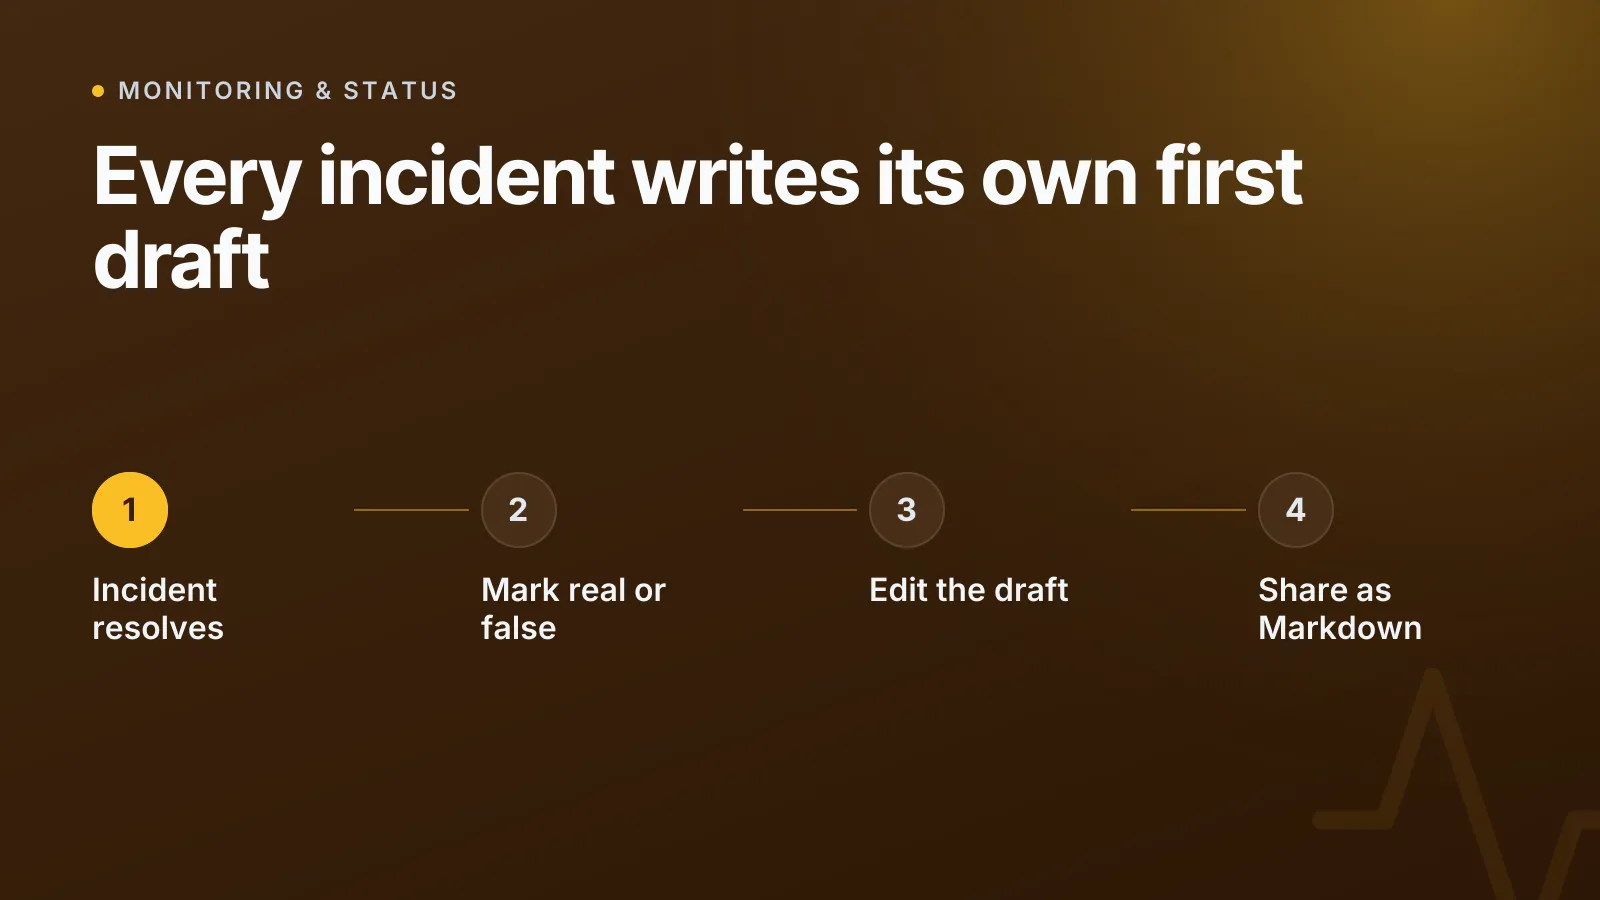
Une fois l'incident résolu, un clic suffit pour répondre à « S'agissait-il d'un vrai problème ? » : vrai problème, fausse alerte ou comportement attendu, avec une cause facultative. Cette réponse compte au-delà de l'archivage : un moniteur qui déclenche régulièrement de fausses alertes se voit proposer le réglage qui corrigerait le problème dans Mieux surveiller, et la suggestion destinée aux moniteurs qui oscillent entre disponible et indisponible ne masque jamais une panne que vous avez marquée comme réelle.
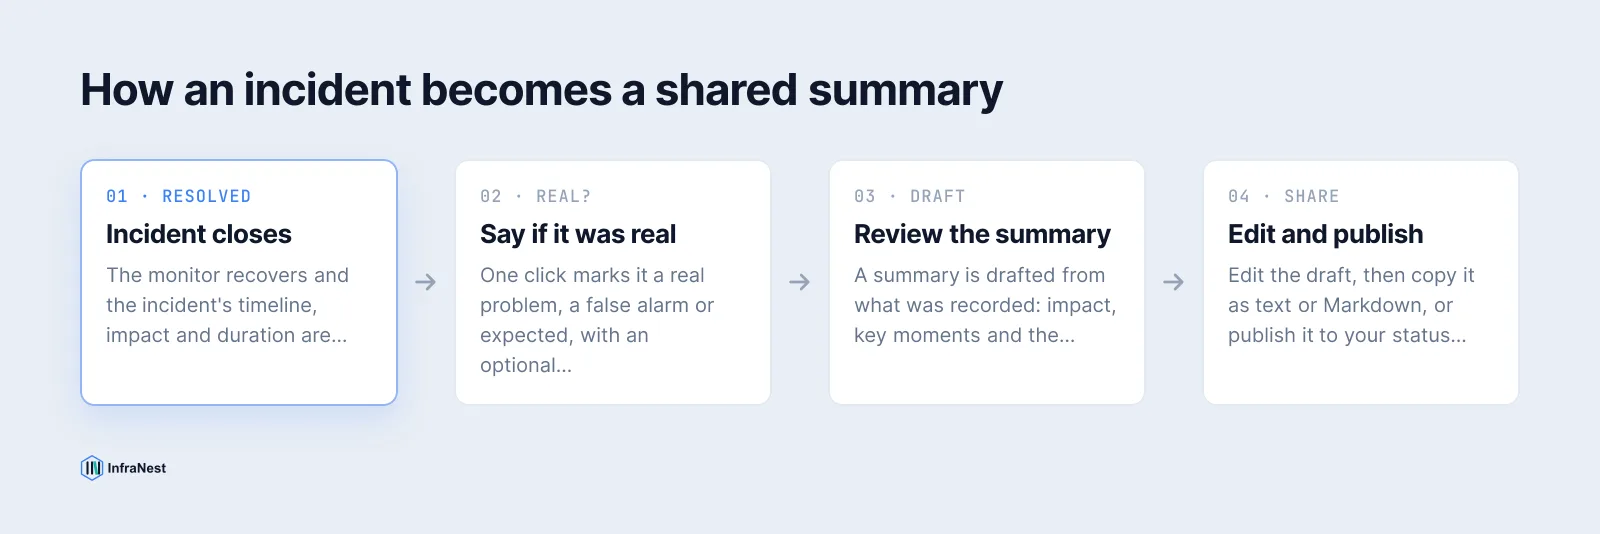
Chaque incident résolu reçoit aussi un rapport rédigé à partir de ce qui a été enregistré : ce qui a été touché et pendant combien de temps, les moments clés, la cause probable et les changements effectués juste avant le début de l'incident. Vous le modifiez, l'enregistrez et le copiez en texte brut ou en Markdown, prêt à coller dans un ticket, une page de wiki ou un canal d'équipe. Le processus de revue complet va plus loin : précisez pourquoi c'est arrivé (ou faites aussi rédiger cette partie, si vous l'avez connectée), listez ligne par ligne ce que vous allez changer, et publiez la revue directement sur votre page de statut, votre outil de documentation, Confluence, Notion ou Linear. Consultez la documentation sur les incidents pour les étapes exactes. Si vous préférez transformer immédiatement les actions de suivi en tâches suivies, découvrez aussi comment ouvrir des tickets Jira ou Linear directement depuis les événements d'infrastructure.
Gardez un langage sans recherche de coupable
Un rapport qui dit « Dave a poussé une mauvaise configuration » n'apprend rien et dissuade la personne suivante d'être honnête au sujet d'une erreur similaire. Un rapport qui dit « le pipeline de déploiement ne comportait aucune vérification capable de détecter cette erreur de configuration » désigne quelque chose que vous pouvez réellement corriger. Décrivez les conditions qui ont rendu l'erreur possible, pas la personne qui l'a commise.
WarningNe réservez pas les rapports aux grosses pannes. Une coupure de deux minutes que personne n'a remarquée est souvent la version précoce du vrai incident du mois prochain, et la tendance n'apparaît que si quelqu'un a aussi consigné les petits.
Rédiger un rapport d'incident court et honnête tant que les détails sont encore frais, c'est l'assurance la moins chère dont dispose votre infrastructure. La prochaine fois qu'une panne survient, commencez par vérifier ce que votre monitoring a déjà capturé, et laissez le premier brouillon s'écrire tout seul.
Questions fréquentes
#Faut-il une revue écrite complète pour chaque incident ?
Non. Réservez l'analyse détaillée du « pourquoi c'est arrivé » aux incidents ayant un réel impact, et contentez-vous de consigner l'impact, la durée et une cause probable pour les incidents mineurs, afin que les données soient disponibles si une tendance apparaît plus tard.
#Qui devrait réellement lire un rapport d'incident ?
Toute personne susceptible d'être alertée pour un problème similaire : l'équipe d'astreinte, le responsable du service et son chef d'équipe, pas seulement la personne qui a corrigé le problème cette fois-ci.
#Quelle est la différence entre un rapport d'incident et une mise à jour de page de statut ?
Une mise à jour de page de statut est courte, publique et rédigée pour les clients pendant que l'incident est en cours. Un rapport d'incident est interne, rédigé après la résolution, et inclut la chronologie et la cause qu'une communication client omet délibérément.
#Un rapport d'incident doit-il nommer la personne à l'origine du problème ?
Non. La rédaction de post-mortems sans recherche de coupable se concentre sur les conditions qui ont permis l'erreur (une vérification manquante, un runbook peu clair, l'absence d'étape canary) plutôt que sur l'individu, car c'est ce que vous pouvez réellement corriger.
Essayez avec un outil gratuit
Cet article vous a-t-il été utile ?