

Behalte Backup-Skripte, Cron-Jobs und geplante Aufgaben im Blick, die nach einem Zeitplan laufen sollen — und werde sofort benachrichtigt, wenn einer still und heimlich nicht mehr läuft. Dieser Artikel richtet sich an alle, die sich auf regelmäßig laufende Jobs verlassen und wissen wollen, wenn das nicht passiert.
#Überblick
- Die meisten Monitore rufen aktiv etwas bei dir ab, um es zu prüfen. Ein Heartbeat-Monitor funktioniert andersherum: Dein Job meldet sich jedes Mal bei InfraNest, wenn er fertig ist.
- Trifft die Meldung nicht rechtzeitig ein, benachrichtigt InfraNest dich — so erkennst du einen Job, der still stehengeblieben ist.
- Du kannst das automatisch einrichten, wenn der InfraNest-Agent auf dem Server läuft, oder manuell für alles andere, einschließlich GitHub-Actions-Workflows.
#Einen Cron-Job auf einem Server mit Agent überwachen
Wenn der InfraNest-Agent auf dem Server läuft, musst du nichts von Hand einrichten:
- Öffne den Server und gehe zu Workloads. Unter Scheduled jobs siehst du jeden Cron-Job und systemd-Timer darauf — wann er jeweils läuft, als welcher Benutzer, und wann er als Nächstes läuft.
- Wähle neben einem deiner Jobs Watch this job. InfraNest legt den Heartbeat-Monitor sofort an und erwartet den Job so oft, wie es sein Zeitplan vorsieht, mit einer Stunde Kulanz für einen nächtlichen Job.
- Ändere eine Zeile auf dem Server: Stelle
infranest-agent run --job "NAME" --vor den Befehl. InfraNest zeigt dir die Zeile vorher und nachher. Zum Beispiel:
# vorher
15 3 * * * root /opt/acme/backup.sh
# nachher
15 3 * * * root infranest-agent run --job "Nightly backup" -- /opt/acme/backup.sh
Das war's schon. Dein Job läuft genau wie vorher, als derselbe Benutzer, und beendet sich mit seinem eigenen Exit-Code. Nach jedem Lauf teilt der Agent InfraNest mit, wann er gestartet wurde, wie lange er gedauert hat und wie er geendet hat — es landet kein Token in deiner Crontab.
- Wenn er fehlschlägt, geht der Monitor auf down, und seine Seite zeigt den Exit-Code und die letzten 20 Zeilen der Job-Ausgabe, mit maskierten Passwörtern und Schlüsseln. Füge
--no-outputhinzu, um nur den Exit-Code zu senden. - Wenn er gar nicht läuft, geht der Monitor nach Ablauf der Kulanzzeit auf down, wie bei jedem Heartbeat.
- InfraNest ändert deine Crontab nie. Der Agent liest sie nur.
NoteInfraNest zeigt die ganze Zeile nur, wenn du Befehlszeilen für den Server eingeschaltet hast, weil Cron-Zeilen oft Passwörter enthalten. Andernfalls zeigt es nur den Teil, der vor deinen Befehl gehört.
Die eigenen Crontabs deiner Benutzer werden nicht aufgelistet: Nur root kann sie lesen, und der Agent läuft nie als root. Jobs in /etc/crontab, /etc/cron.d und den Ordnern cron.daily, hourly, weekly und monthly dagegen schon. Ein Skript in einem dieser Ordner oder ein systemd-Timer kann so nicht umschlossen werden — nutze dafür stattdessen die Ping-URL unten.
Wenn Scheduled jobs meldet, dass der Agent keinen Ordner für Job-Berichte hat, führe den Installer des Agents erneut mit --upgrade aus; er legt den Ordner an, in den die Berichte geschrieben werden.
Würde ein Wartungsfenster starten, während ein Job läuft, warnt dich Scheduled jobs und bietet an, das Fenster darüber hinaus zu verschieben.
#Einen Heartbeat von Hand einrichten
- Gehe zu Monitors und wähle Add.
- Wähle Heartbeat / Cron monitor als Typ.
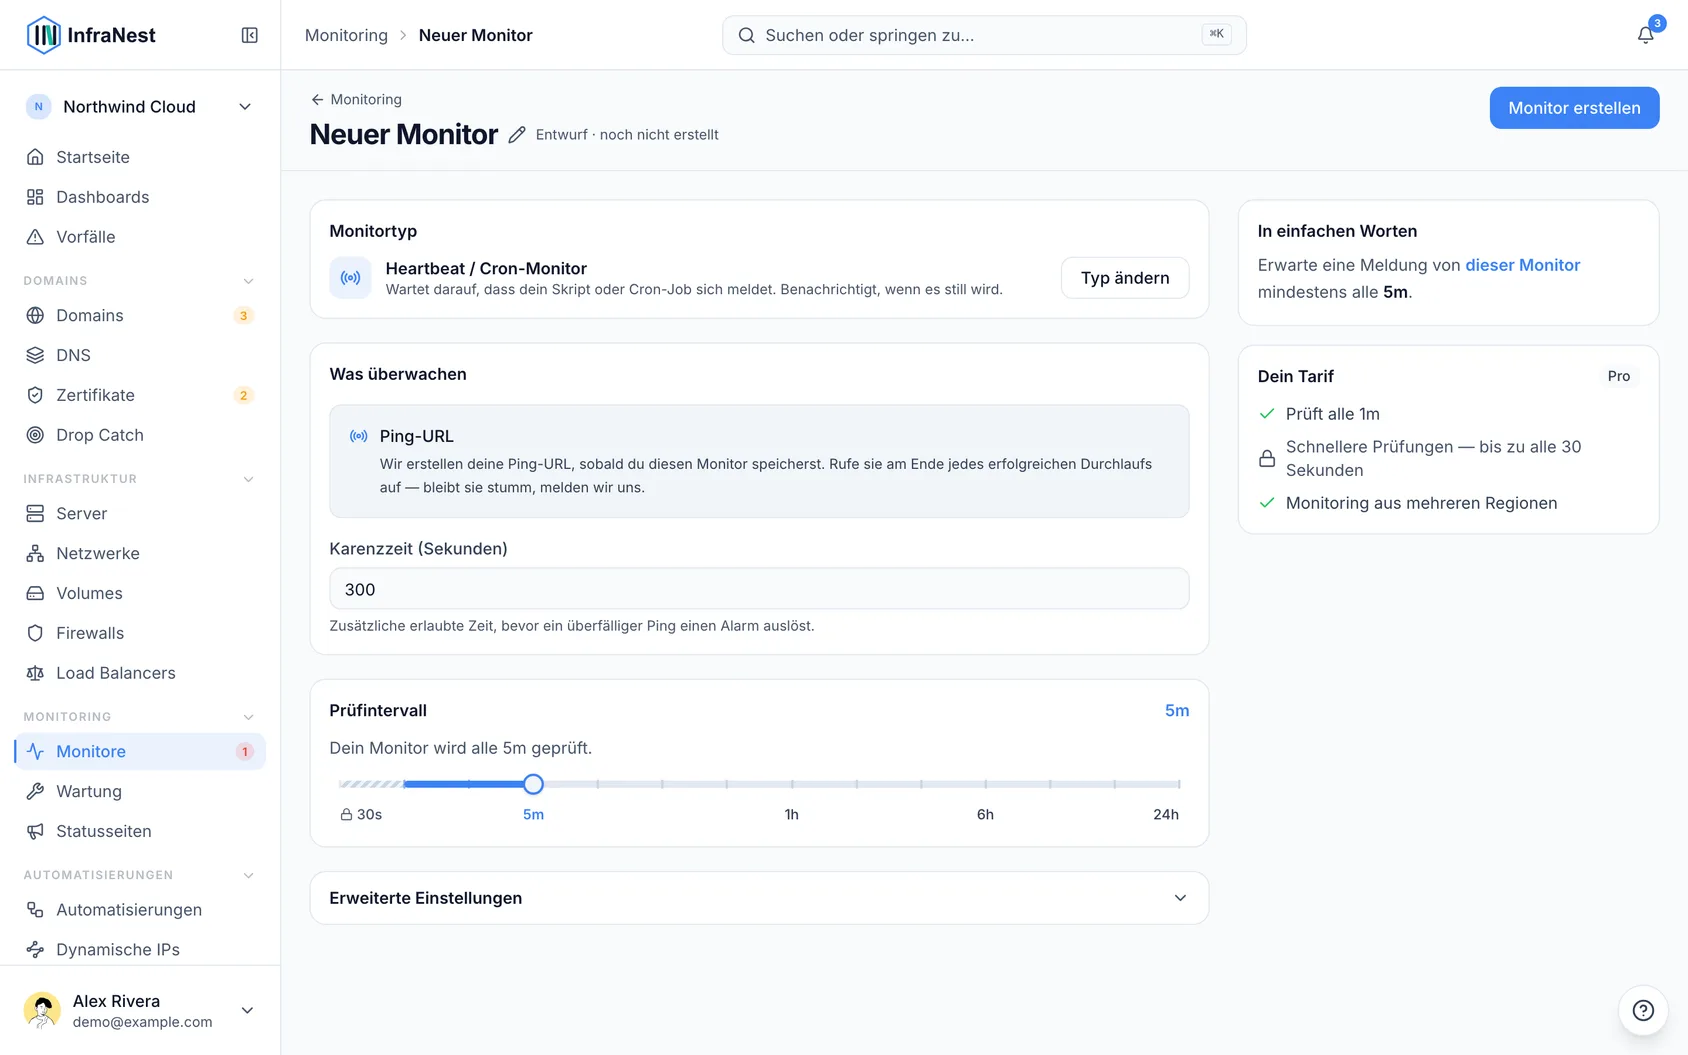
- Gib ihm einen Namen, den du in einer Benachrichtigung wiedererkennst — „Nightly database backup“ ist besser als „job 1“.
- Setze das check interval darauf, wie oft der Job laufen soll.
- Setze eine Kulanzzeit — zusätzliche Zeit, die InfraNest zulässt, bevor es ihn als verspätet meldet. Ein Backup, das normalerweise vier Minuten dauert, aber gelegentlich acht, braucht eine Kulanzzeit, die deutlich länger ist als diese Überschreitung.
- Wähle Create.
Für diesen Typ gibst du keine URL ein — InfraNest erstellt dir beim Speichern eine.
#Deinen Job sich melden lassen
Öffne den Monitor, und du siehst seine Ping-URL sowie eine fertige Einzeiler-Zeile zum Einfügen. Füge diese Zeile an das Ende deines Skripts oder Cron-Jobs, damit sie nur läuft, wenn der Job tatsächlich erfolgreich war:
0 3 * * * /usr/local/bin/backup.sh && curl -fsS -m 10 --retry 3 https://your-infranest-url/api/heartbeat/your-uuid
Das && ist entscheidend: Es bedeutet, dass die Meldung nur erfolgt, wenn das Backup selbst erfolgreich beendet wurde. Ein fehlgeschlagener Job bleibt dann still, und genau diese Stille löst den Alarm aus.
Verwende Copy, statt die URL neu einzutippen — die Kennung darin ist eindeutig für diesen Monitor.
#Die Laufzeit des Jobs melden
Füge ?duration= mit der Laufzeit des Jobs in Sekunden an die Ping-URL an, und der Monitor zeigt Last run took neben dem letzten Ping an. Ein Job, der jede Nacht ein bisschen länger dauert, lässt sich so erkennen, bevor er seine Kulanzzeit überschreitet. Zum Beispiel in einem Skript:
start=$(date +%s)
/usr/local/bin/backup.sh && curl -fsS -m 10 --retry 3 "https://your-infranest-url/api/heartbeat/your-uuid?duration=$(( $(date +%s) - start ))"
Nachkommastellen sind erlaubt (?duration=4.25). Ist der Wert keine Zahl, zählt die Meldung trotzdem — nur die Laufzeit wird dann nicht übernommen.
#Aus einem GitHub-Actions-Workflow
Wenn dein Backup, deine Erneuerung oder dein nächtlicher Sync als geplanter GitHub-Actions-Workflow läuft, funktioniert derselbe Monitor — der Workflow meldet sich als letzter Schritt.
- Öffne in deinem Repository auf GitHub Settings → Secrets and variables → Actions und füge ein Repository-Secret namens
HEARTBEAT_URLmit der Ping-URL als Wert hinzu. - Füge diesen Schritt an das Ende des Jobs:
      - name: Check in with InfraNest
        run: curl -fsS -m 10 --retry 3 "$HEARTBEAT_URL"
        env:
          HEARTBEAT_URL: ${{ secrets.HEARTBEAT_URL }}
GitHub überspringt die restlichen Schritte, sobald einer fehlschlägt, sodass die Meldung nur erfolgt, wenn alles davor erfolgreich war — derselbe Effekt wie das && oben.
Das erfasst außerdem etwas, worüber GitHub dich nicht deutlich informiert: In einem öffentlichen Repository schaltet GitHub geplante Workflows nach 60 Tagen ohne jede Aktivität im Repository ab. Der Workflow läuft dann nicht mehr, nichts schlägt fehl, und die fehlende Meldung ist es, die den Alarm auslöst.
TipGitHub kann geplante Workflows bei hoher Auslastung mehrere Minuten verspätet starten. Gib dem Monitor eine Kulanzzeit, die das zusätzlich zur eigentlichen Laufzeit des Jobs berücksichtigt.
#Was als Nächstes passiert
- Jede Meldung markiert den Monitor als Aktiv und speichert den Zeitpunkt als letzten Ping.
- Ein brandneuer Monitor bleibt ausstehend, bis sein erstes Zeitfenster vergangen ist, damit du Zeit hast, die Meldung einzurichten, ohne deswegen benachrichtigt zu werden.
- Trifft innerhalb des Intervalls plus der Kulanzzeit nichts ein, geht der Monitor auf down und eröffnet einen Vorfall, sodass deine üblichen Benachrichtigungsziele auslösen.
- Die nächste Meldung löst den Vorfall auf und benachrichtigt dich, dass alles wieder läuft — du musst ihn nicht von Hand schließen.
#Tipps
- Das Pausieren eines Heartbeat-Monitors ist unbedenklich: Die Ping-URL antwortet weiterhin normal, sodass ein Job, der sich weiterhin meldet, keine Fehler zu melden beginnt. InfraNest hört einfach auf zu überwachen, bis du fortsetzt.
- Behandle die Ping-URL wie ein Geheimnis. Wer sie kennt, kann deinen Job als gesund melden — was einen echten Ausfall verdecken würde.
#Fehlerbehebung
- No ping received yet am Monitor bedeutet, dass InfraNest noch gar nichts vom Job gehört hat. Führe die curl-Zeile von Hand auf derselben Maschine aus: Wird der Monitor dadurch grün, liegt das Problem in deinem Skript, nicht hier.
- Kann die Maschine nicht ausgehend ins Internet, kann die Meldung nicht ankommen — erlaube ausgehendes HTTPS zu InfraNest.
- Ein Monitor, der jede Nacht zur gleichen Zeit Alarm schlägt, hat meist eine Kulanzzeit, die kürzer ist als die tatsächliche längste Laufzeit des Jobs.
War dieser Artikel hilfreich?
Danke für dein Feedback!
Danke, das geht direkt an das Docs-Team.